提示技术
零样本提示
没有向模型提供示例
少样本提示(few-shot)
提供少量示例以激发上下文学习
限制:处理复杂任务
链式思考提示(Chain-of-Thought Prompting)
CoT提示通过中间推理步骤实现了复杂的推理能力 可以与few-shot结合
零样本COT提示
基本上涉及"将让我们逐步思考"添加到原始提示中
自动思维链
当思维链提示时,需要手工制作有效且多样化的例子,可能会导致次优解决方案
消除人工的方法:
Auto-CoT主要由两个阶段组成:
- 阶段一:问题聚类:将给定问题分为几个聚类
- 阶段二:演示抽样:从每组数组中选择一个具有代表性的问题,并且使用简单启发式的Zero-Shot-Cot生成其推理链
自我一致性
旨在"替换链式思维提示中使用的天真贪婪解码方法" 通过少量CoT采样多种不同的推理路径,并使用生成结构选择最一致的答案 核心:Prompt中提供多种推理链,选择一致的答案
生成知识提示
生成知识作为提示的一部分
Prompt Chain
将任务拆解为许多子任务,确定子任务之后,将子任务的提示词提供给LLM,得到的结果作为提示作为新的提示词的一部分 链式提示(prompt chain):一个任务被分解为多个子任务,根据子任务创建一系列提示操作
提高了控制性和可靠性,可容易定位模型中的问题,并分析改进需要提高的不同阶段的性能
示例文档问答中的链式提示
提示链可以用于不同的场景,这些场景可能涉及多个操作或转换。例如,LLM 的一个常见用途是根据大型文本文档回答问题。想要更好阅读大文本文档,可以设计两个不同的提示,第一个提示负责提取相关引文以回答问题,第二个提示则以引文和原始文档为输入来回答给定的问题。换句话说,可以创建两个不同的提示来执行根据文档回答问题的任务。
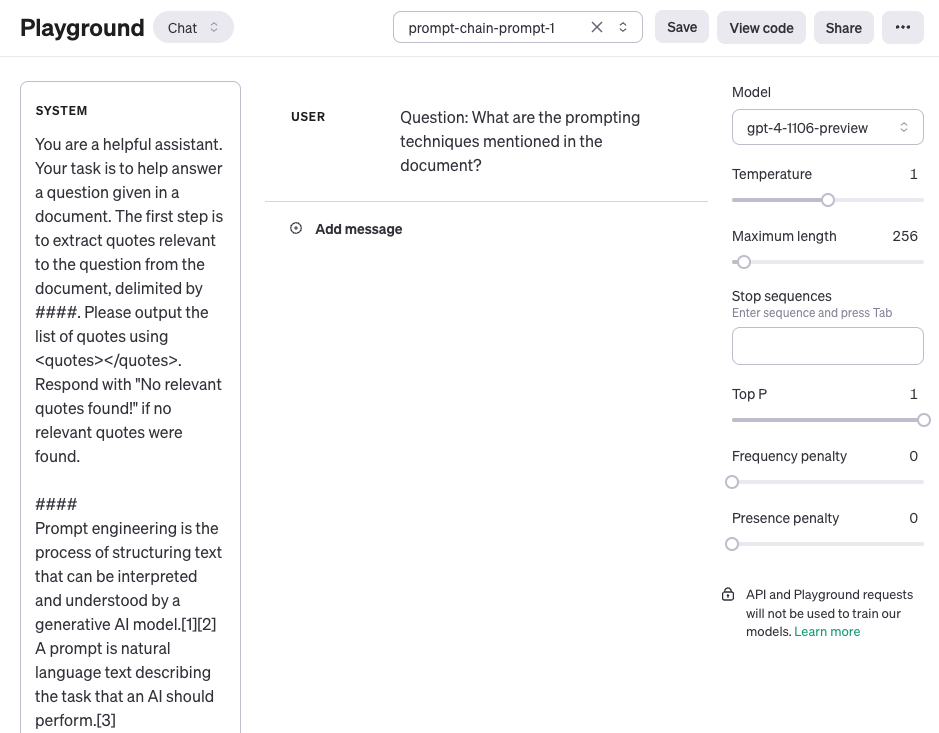
下面的第一个提示根据问题从文档中提取相关引文。请注意,为了简化,我们为文档添加了一个占位符{{文档}}。要测试此提示,您可以从维基百科复制并粘贴一篇文章,例如这个关于提示工程的页面。由于此任务使用了较长的上下文,我们使用了 OpenAI 的 gpt-4-1106-preview 模型。您也可以将此提示与其他长上下文 LLM(如 Claude)一起使用。
提示 1:
| |
这是整个提示的截图,包括通过 user 角色传递的问题。
提示 1 的输出:
| |
在第一个提示中返回的引文现在可以用作下面第二个提示的输入。您可以对这些引文进行清理,比如移除引用标志。可以在提示链中新建另一个提示来移除或使用这些引用标志,但现在您可以忽略这些。然后,第二个提示接收由第一个提示提取的相关引文,并根据文档和这些提取的引文生成一个有帮助的回答。第二个提示可以是以下内容:
提示 2:
| |
提示 2 的输出:
| |
如您所见,简化并创建提示链是一种有用的提示方法,其中响应需要经过多个操作或转换。作为练习,您可以自由设计一个提示,它会在将响应作为最终回应发送给应用程序用户之前,移除响应中的引用标志(例如,[27])。
您还可以在这份文档中找到更多关于提示链的示例,这些示例利用了 Claude LLM。我们的示例灵感来源于他们,并采用了他们的示例。
思维树(ToT)
Tree of Thoughts,ToT:基于思维链提示进行了总结,引导LM把思维作为中间步骤解决同通用问题
ToT 维护着一棵思维树,思维由连贯的语言序列表示,这个序列就是解决问题的中间步骤
检索增强生成(RAG)
完成复杂的知识密集型的任务
将一个信息检索组件和文本生成模型结合在一起 接受输入并检索出一组相关/支撑的文档,并给出文档的来源,这些文档作为上下文和输入的原始提示词组合,送给文本生成器得到最终的输出
自动推理并使用工具(ART)
交替使用Cot提示和工具被证明为一种强大且稳健的方法,但是这些方法需要针对特定任务手写规范还要精心编写交替使用生成模型和工具的脚本
ART(Automatic Reasoning and Tool-use)的工作原理如下:
- 接受一个新任务时,从任务库选择多部推理和使用工具的示范
- 在测试中,调用外部工具时,先暂停生成,将工具输出整合后继续生成
自动提示工程师(APE)
用于自动指令生成和选择的框架 指令生成问题被构建为自然语言合成问题,使用 LLMs 作为黑盒优化问题的解决方案来生成和搜索候选解。 第一步涉及一个大型语言模型(作为推理模型),该模型接收输出演示以生成任务的指令候选项。这些候选解将指导搜索过程。使用目标模型执行指令,然后根据计算的评估分数选择最合适的指令
Active-Prompt
第一步是使用或不使用少量 CoT 示例查询 LLM。对一组训练问题生成 k 个可能的答案。基于 k 个答案计算不确定度度量(使用不一致性)。选择最不确定的问题由人类进行注释。然后使用新的注释范例来推断每个问题 人类干预
方向性刺激提示
训练了一个可调节的策略 LM 来生成刺激/提示。越来越多地使用RL来优化 LLM。
PAL(程序辅助语言框架)
不通过自由形式我呢本来获取解决方法,将解决步骤卸载到类似于Python解释器的编程运行时中
ReAct框架
以交错的方式生成推理轨迹和任务特定操作
如何运作的
将推理和行为与LLMs相结合通用的范例 ReAct提示LLMs为任务生成口头轨迹和操作,使得系统执行动态推理来创建,维护和调整操作计划,同时还支持与外部环境的交互,将额外信息合并到推理中
ReAct提示
第一步:从训练集中选择案例,并组成ReAct格式的轨迹下面是一个 ReAct 提示的示例(摘自论文,为简单起见缩短为一个示例):
| |
多思考-操作-观察步骤用于任务-解决轨迹
总而言之:
- CoT 存在事实幻觉的问题
- ReAct 的结构性约束降低了它在制定推理步骤方面的灵活性
- ReAct 在很大程度上依赖于它正在检索的信息;非信息性搜索结果阻碍了模型推理,并导致难以恢复和重新形成思想
长链 ReAct 的使用
下面是 ReAct 提示方法在实践中如何工作的高阶示例。我们将在 LLM 和 长链 中使用OpenAI,因为它已经具有内置功能,可以利用 ReAct 框架构建代理,这些代理能够结合 LLM 和其他多种工具的功能来执行任务。
首先,让我们安装并导入必要的库:
| |
现在我们可以配置 LLM,我们要用到的工具,以及允许我们将 ReAct 框架与 LLM 和其他工具结合使用的代理。请注意,我们使用搜索 API 来搜索外部信息,并使用 LLM 作为数学工具。
| |
配置好之后,我们就可以用所需的查询或提示运行代理了。请注意,在这里,我们不会像论文中阐释的那样提供少样本的示例。
| |
链执行如下所示:
| |
我们得到如下输出:
| |
Reflexion(自我反思)
通过语言反馈来强化基于语言的智能体的框架
在高层次上,自我反思将来自环境的反馈(自由形式的语言或者标量)转换为语言反馈,也被称作 self-reflection,为下一轮中 LLM 智能体提供上下文。
如上图所示,自我反思由三个不同的模型组成:
- 参与者(Actor):根据状态观测量生成文本和动作。参与者在环境中采取行动并接受观察结果,从而形成轨迹。链式思考(CoT) 和 ReAct 被用作参与者模型。此外,还添加了记忆组件为智能体提供额外的上下文信息。
- 评估者(Evaluator):对参与者的输出进行评价。具体来说,它将生成的轨迹(也被称作短期记忆)作为输入并输出奖励分数。根据人物的不同,使用不同的奖励函数(决策任务使用LLM和基于规则的启发式奖励)。
- 自我反思(Self-Reflection):生成语言强化线索来帮助参与者实现自我完善。这个角色由大语言模型承担,能够为未来的试验提供宝贵的反馈。自我反思模型利用奖励信号、当前轨迹和其持久记忆生成具体且相关的反馈,并存储在记忆组件中。智能体利用这些经验(存储在长期记忆中)来快速改进决策。
何时自我反思?
- 智能体需要从错误和尝试中学习
- 传统的强化学习方法失效
- 需要细致入微的反馈
- 可解释性和直接记忆很重要
自我反思在以下任务中是有效的:
- 序列决策:自我反思提高了智能体在 AlfWorld 任务中的表现,涉及在各种环境中导航并完成多步目标。
- 推理:自我反思提高了 HotPotQA 上智能体的性能,HotPotQA 是一个需要对多个文档进行推理的问答数据集。
- 编程:自我反思的智能体在 HumanEval 和 MBPP 等基准测试上编写出了更好的代码,在某些情况下实现 SOTA 结果。
以下是自我反思的一些限制:
- 依赖自我评估能力:反思依赖于智能体准确评估其表现并产生有用反思的能力。这可能是具有挑战性的,尤其是对于复杂的任务,但随着模型功能的不断改进,预计自我反思会随着时间的推移而变得更好。
- 长期记忆限制:自我反思使用最大容量的滑动窗口,但对于更复杂的任务,使用向量嵌入或 SQL 数据库等高级结构可能会更有利。
- 代码生成限制:测试驱动开发在指定准确的输入输出映射方面存在限制(例如,受硬件影响的非确定性生成器函数和函数输出)。