2.1 注意力机制#
2.1.1 什么是注意力机制#
从计算机视觉为起源发展起来的神经网络,其核心架构有三种
- 前馈神经网络(Feedforward Neural Network,FNN),即数据从输入层单向流动到输出层,无循环结构,各层之间通过全连接或特定方式传递信息,其中多层感知机(Multi-Layer Perceptron,MLP)是最常见的形式,每一层的神经元都和上下两层的每一个神经元完全连接,如图2.1所示:
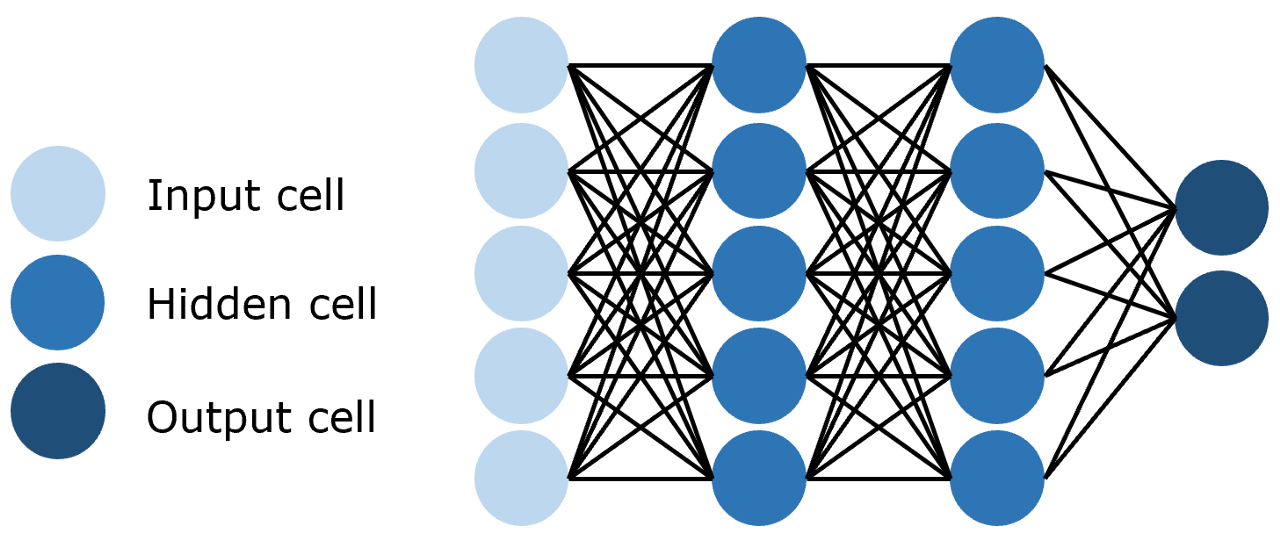
图2.1 全连接神经网络
- 卷积神经网络(Convolutional Neural Network,CNN),即训练参数量远小于全连接神经网络的卷积层来进行特征提取和学习,如图2.2所示:
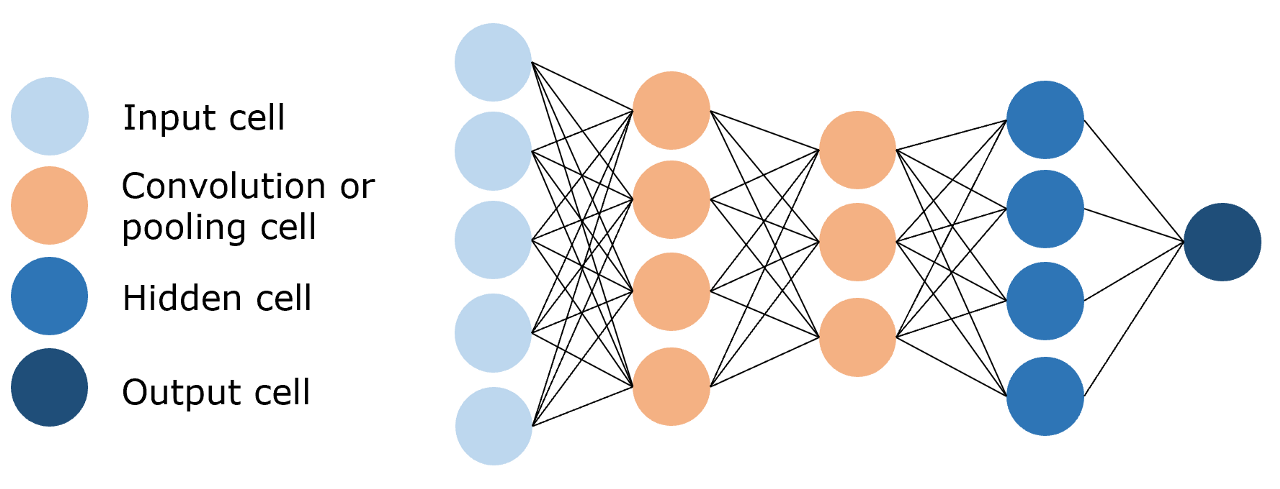
图2.2 卷积神经网络
- 循环神经网络(Recurrent Neural Network,RNN),能够使用历史信息作为输入、包含环和自重复的网络,如图2.3所示:
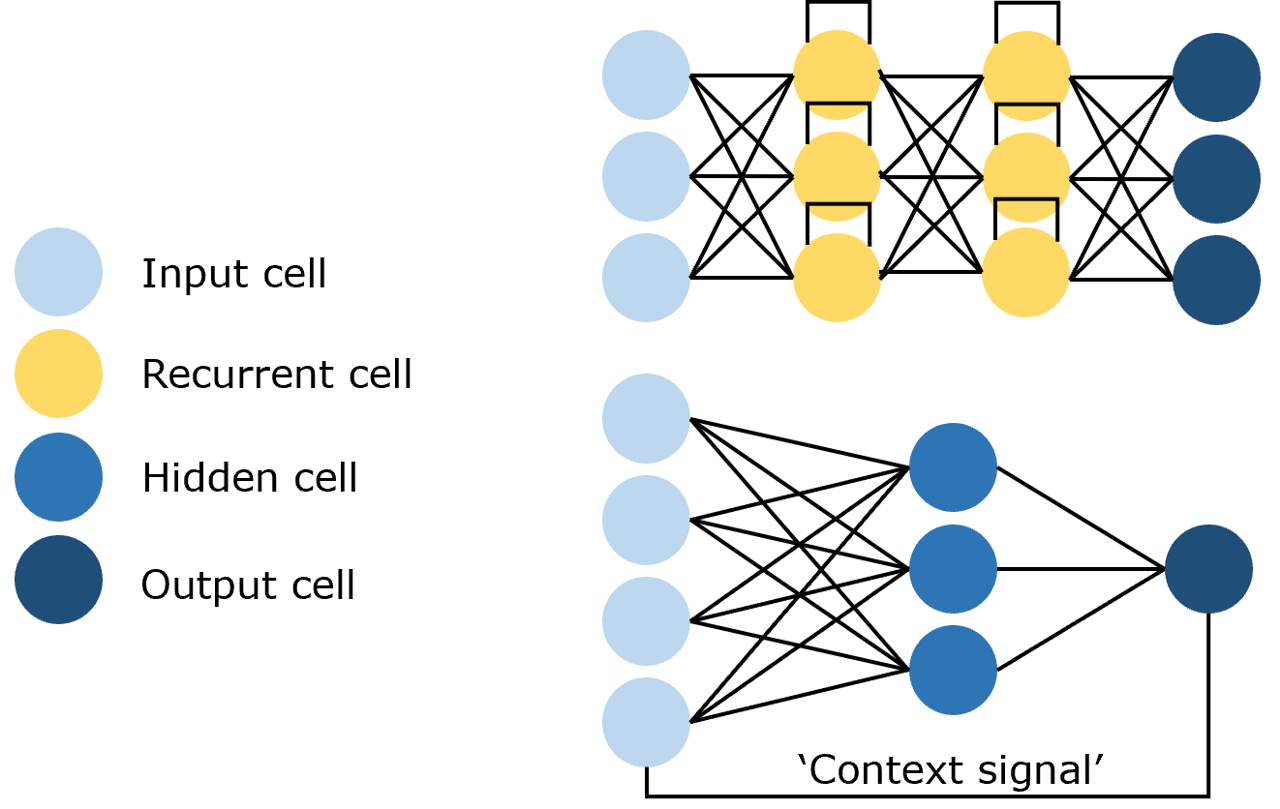
由于 NLP 任务所需要处理的文本往往是序列,因此专用于处理序列、时序数据的 RNN 往往能够在 NLP 任务上取得最优的效果
虽然RNN及LSTM具有捕捉时序信息,适合序列生成的优点,却有两个难以弥补的缺陷:
1.序列依序计算的模式能够很好地模拟时序信息,但是限制了计算机并行计算的能力
2.RNN难以捕捉长序列的相关关系
什么是注意力机制呢?
核心思想:将重点注意力集中在一个或者几个Token,从而取得更高效高质的计算效果
三个核心变量:Query(查寻值),Key(键值),Value(真值):
一个例子方便理解,可看可不看:
当我们有一篇新闻报道,我们想要找到这个报道的时间,那么,我们的 Query 可以是类似于“时间”、“日期”一类的向量(为了便于理解,此处使用文本来表示,但其实际是稠密的向量),Key 和 Value 会是整个文本。通过对 Query 和 Key 进行运算我们可以得到一个权重,这个权重其实反映了从 Query 出发,对文本每一个 token 应该分布的注意力相对大小。通过把权重和 Value 进行运算,得到的最后结果就是从 Query 出发计算整个文本注意力得到的结果。
注意力机制的特点是通过计算 Query 与Key的相关性为真值加权求和,从而拟合序列中每个词同其他词的相关关系。
2.1.2 深入理解注意力机制#
给不同 Key 所赋予的不同权重,就是我们所说的注意力分数,也就是为了查询到 Query,我们应该赋予给每一个 Key 多少注意力
但是,如何针对每一个 Query,计算出对应的注意力分数呢?从直观上讲,我们可以认为 Key 与 Query 相关性越高,则其所应该赋予的注意力权重就越大。但是,我们如何能够找到一个合理的、能够计算出正确的注意力分数的方法呢
$$
v \cdot w = \sum_i v_i w_i
$$
根据词向量的定义,语义相似的两个词对应的词向量的点积应该大于 0,而语义不相似的词向量点积应该小于 0。
那么,我们就可以用点积来计算词之间的相似度。假设我们的 Query 为“fruit”,对应的词向量为 q;我们的 Key 对应的词向量为:
$$
K=\begin{bmatrix} v_{\text{apple}} \ v_{\text{banana}} \ v_{\text{chair}} \end{bmatrix}
$$
则我们可以计算 Query 和每一个 Key 的相似程度:
$$
x = qK^T
$$
此处的 K 即为将所有 Key 对应的词向量堆叠形成的矩阵。基于矩阵乘法的定义,x 即为 q 与每一个 Key 向量的点积。
现在我们得到的 x 即反映了 Query 和每一个 Key 的相似程度,我们再通过一个 Softmax 层将其转化为和为 1 的权重:
$$
\operatorname{softmax}(x)_i = \frac{e^{x_i}}{\sum_j e^{x_j}}
$$
这样,得到的向量就能够反映 Query 和每一个 Key 的相似程度,同时所有权重相加为 1,也就是我们的注意力分数。
最后,我们再将得到的注意力分数和值向量做对应乘积即可。根据上述过程,我们就可以得到注意力机制计算的基本公式:
$$
\operatorname{Attention}(Q,K,V) = \operatorname{softmax}(qK^T)V
$$
不过,此时的值还是一个标量,同时,我们此次只查询了一个 Query。我们可以将值转化为维度为 d_v 的向量,同时一次性查询多个 Query,同样将多个 Query 对应的词向量堆叠在一起形成矩阵 Q,得到公式:
$$
\operatorname{Attention}(Q,K,V) = \operatorname{softmax}(QK^T)V
$$
目前,我们离标准的注意力机制公式还差最后一步。在上一个公式中,如果 Q 和 K 对应的维度 d_k 比较大,QK^T 的结果数值可能会变得较大,使 Softmax 输出过于集中,从而影响梯度的稳定性。因此,我们要将 Q 和 K 乘积的结果做一个缩放:
$$
\operatorname{Attention}(Q,K,V) = \operatorname{softmax} \left( \frac{QK^T}{\sqrt{d_k}} \right)V
$$
2.1.3 注意力机制的实现#
使用Pytorch
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
| '''注意力计算函数'''
def attention(query, key, value, dropout=None):
'''
args:
query: 查询值矩阵
key: 键值矩阵
value: 真值矩阵
'''
# 获取键向量的维度,键向量的维度和值向量的维度相同
d_k = query.size(-1)
# 计算Q与K的内积并除以根号dk
# transpose——相当于转置
scores = torch.matmul(query, key.transpose(-2, -1)) / math.sqrt(d_k)
# Softmax
p_attn = scores.softmax(dim=-1)
if dropout is not None:
p_attn = dropout(p_attn)
# 采样
# 根据计算结果对value进行加权求和
return torch.matmul(p_attn, value), p_attn
|
2.1.4 自注意力#
注意力机制的本质是对两段序列的元素依次进行相似度计算,寻找出一个序列的每个元素对另一个序列的每个元素的相关度,然后基于相关度进行加权,即分配注意力。而这两段序列即是我们计算过程中 Q、K、V 的来源
但是,在我们的实际应用中,我们往往只需要计算 Query 和 Key 之间的注意力结果,很少存在额外的真值 Value。也就是说,我们其实只需要拟合两个文本序列。在经典的 注意力机制中,Q 往往来自于一个序列,K 与 V 来自于另一个序列,都通过参数矩阵计算得到,从而可以拟合这两个序列之间的关系。例如在 Transformer 的 Decoder 结构中,Q 来自于 Decoder 的输入,K 与 V 来自于 Encoder 的输出,从而拟合了编码信息与历史信息之间的关系,便于综合这两种信息实现未来的预测。
但在 Transformer 的 Encoder 结构中,使用的是 注意力机制的变种 —— 自注意力(self-attention,自注意力)机制。所谓自注意力,即是计算本身序列中每个元素对其他元素的注意力分布,即在计算过程中,Q、K、V 都由同一个输入通过不同的参数矩阵计算得到。在 Encoder 中,Q、K、V 分别是输入对参数矩阵 Wq、Wk、WvW**q、W**k、W**v 做积得到,从而拟合输入语句中每一个 token 对其他所有 token 的关系。
通过自注意力机制,我们可以找到一段文本中每一个 token 与其他所有 token 的相关关系大小,从而建模文本之间的依赖关系。在代码中的实现,self-attention 机制其实是通过给 Q、K、V 的输入传入同一个参数实现的:
1
2
| # attention 为上文定义的注意力计算函数
attention(x, x, x)
|
2.1.5 掩码自注意力#
掩码自注意力,即 Mask Self-Attention,是指使用注意力掩码的自注意力机制。掩码的作用是遮蔽一些特定位置的 token,模型在学习的过程中,会忽略掉被遮蔽的 token。
使用注意力掩码的核心动机是让模型只能使用历史信息进行预测而不能看到未来信息
使用注意力机制的 Transformer 模型也是通过类似于 n-gram 的语言模型任务来学习的
例子:如,如果待学习的文本序列是 【BOS】I like you【EOS】,那么,模型会按如下顺序进行预测和学习:
1
2
3
4
| Step 1:输入 【BOS】,输出 I
Step 2:输入 【BOS】I,输出 like
Step 3:输入 【BOS】I like,输出 you
Step 4:输入 【BOS】I like you,输出 【EOS】
|
但是上述过程是一个串行的过程,计算效率很低
针对这个问题,Transformer 就提出了掩码自注意力的方法掩码自注意力会生成一串掩码,来遮蔽未来信息。例如,我们待学习的文本序列仍然是 【BOS】I like you【EOS】,我们使用的注意力掩码是【MASK】,那么模型的输入为:
1
2
3
4
5
| <BOS> 【MASK】【MASK】【MASK】【MASK】
<BOS> I 【MASK】 【MASK】【MASK】
<BOS> I like 【MASK】【MASK】
<BOS> I like you 【MASK】
<BOS> I like you </EOS>
|
上述输入不再是串行的过程,而可以一起并行地输入到模型中
观察掩码发现:是一个和文本序列等长的上三角矩阵
我们可以简单地通过创建一个和输入同等长度的上三角矩阵作为注意力掩码,再使用掩码来遮蔽掉输入即可为注意力掩码,再使用掩码来遮蔽掉输入即可。也就是说,当输入维度为 (batch_size, seq_len, hidden_size)时,我们的 Mask 矩阵维度一般为 (1, seq_len, seq_len)(通过广播实现同一个 batch 中不同样本的计算)。
在具体实现中,我们通过以下代码生成 Mask 矩阵:
1
2
3
4
5
| # 创建一个上三角矩阵,用于遮蔽未来信息。
# 先通过 full 函数创建一个 1 * seq_len * seq_len 的矩阵
mask = torch.full((1, args.max_seq_len, args.max_seq_len), float("-inf"))
# triu 函数的功能是创建一个上三角矩阵
mask = torch.triu(mask, diagonal=1)
|
生成的 Mask 矩阵会是一个上三角矩阵,上三角位置的元素均为 -inf,其他位置的元素置为0。
在注意力计算时,我们会将计算得到的注意力分数与这个掩码做和,再进行 Softmax 操作:
1
2
3
| # 此处的 scores 为计算得到的注意力分数,mask 为上文生成的掩码矩阵
scores = scores + mask[:, :seqlen, :seqlen]
scores = F.softmax(scores.float(), dim=-1).type_as(xq)Copy to clipboardErrorCopied
|
通过做求和,上三角区域(也就是应该被遮蔽的 token 对应的位置)的注意力分数结果都变成了 -inf,而下三角区域的分数不变。再做 Softmax 操作,-inf 的值在经过 Softmax 之后会被置为 0,从而忽略了上三角区域计算的注意力分数,从而实现了注意力遮蔽。
2.1.6 多头注意力#
注意力机制可以实现并行化与长期依赖关系拟合,但一次注意力计算只能拟合一种相关关系,单一的注意力机制很难全面拟合语句序列里的相关关系
因此 Transformer 使用了多头注意力机制(Multi-Head Attention),即同时对一个语料进行多次注意力计算,每次注意力计算都能拟合不同的关系,将最后的多次结果拼接起来作为最后的输出,即可更全面深入地拟合语言信息。
事实上,所谓的多头注意力机制其实就是将原始的输入序列进行多组的自注意力处理;然后再将每一组得到的自注意力结果拼接起来,再通过一个线性层进行处理,得到最终的输出。我们用公式可以表示为:
1
2
3
| \operatorname{MultiHead}(Q,K,V)
=
\operatorname{Concat}(\operatorname{head}_1,\ldots,\operatorname{head}_h)W^O
|
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
| import torch.nn as nn
import torch
'''多头自注意力计算模块'''
class MultiHeadAttention(nn.Module):
def __init__(self, args: ModelArgs, is_causal=False):
# 构造函数
# args: 配置对象
super().__init__()
# 隐藏层维度必须是头数的整数倍,因为后面我们会将输入拆成头数个矩阵
assert args.dim % args.n_heads == 0
# 每个头的维度,等于模型维度除以头的总数。
self.head_dim = args.dim // args.n_heads
self.n_heads = args.n_heads
# Wq, Wk, Wv 参数矩阵,每个参数矩阵为 n_embd x dim
# 这里通过三个组合矩阵来代替了n个参数矩阵的组合,其逻辑在于矩阵内积再拼接其实等同于拼接矩阵再内积,
# 不理解的读者可以自行模拟一下,每一个线性层其实相当于n个参数矩阵的拼接
self.wq = nn.Linear(args.n_embd, self.n_heads * self.head_dim, bias=False)
self.wk = nn.Linear(args.n_embd, self.n_heads * self.head_dim, bias=False)
self.wv = nn.Linear(args.n_embd, self.n_heads * self.head_dim, bias=False)
# 输出权重矩阵,维度为 dim x dim(head_dim = dim / n_heads)
self.wo = nn.Linear(self.n_heads * self.head_dim, args.dim, bias=False)
# 注意力的 dropout
self.attn_dropout = nn.Dropout(args.dropout)
# 残差连接的 dropout
self.resid_dropout = nn.Dropout(args.dropout)
self.is_causal = is_causal
# 创建一个上三角矩阵,用于遮蔽未来信息
# 注意,因为是多头注意力,Mask 矩阵比之前我们定义的多一个维度
if is_causal:
mask = torch.full((1, 1, args.max_seq_len, args.max_seq_len), float("-inf"))
mask = torch.triu(mask, diagonal=1)
# 注册为模型的缓冲区
self.register_buffer("mask", mask)
def forward(self, q: torch.Tensor, k: torch.Tensor, v: torch.Tensor):
# 获取批次大小和序列长度,[batch_size, seq_len, dim]
bsz, seqlen, _ = q.shape
# 计算查询(Q)、键(K)、值(V),输入通过参数矩阵层,维度为 (B, T, n_embed) x (n_embed, dim) -> (B, T, dim)
xq, xk, xv = self.wq(q), self.wk(k), self.wv(v)
# 将 Q、K、V 拆分成多头,维度为 (B, T, n_head, dim // n_head),然后交换维度,变成 (B, n_head, T, dim // n_head)
# 因为在注意力计算中我们是取了后两个维度参与计算
# 为什么要先按B*T*n_head*C//n_head展开再互换1、2维度而不是直接按注意力输入展开,是因为view的展开方式是直接把输入全部排开,
# 然后按要求构造,可以发现只有上述操作能够实现我们将每个头对应部分取出来的目标
xq = xq.view(bsz, seqlen, self.n_heads, self.head_dim)
xk = xk.view(bsz, seqlen, self.n_heads, self.head_dim)
xv = xv.view(bsz, seqlen, self.n_heads, self.head_dim)
xq = xq.transpose(1, 2)
xk = xk.transpose(1, 2)
xv = xv.transpose(1, 2)
# 注意力计算
# 计算 QK^T / sqrt(d_k),维度为 (B, nh, T, hs) x (B, nh, hs, T) -> (B, nh, T, T)
scores = torch.matmul(xq, xk.transpose(2, 3)) / math.sqrt(self.head_dim)
# 掩码自注意力必须有注意力掩码
if self.is_causal:
assert hasattr(self, 'mask')
# 这里截取到序列长度,因为有些序列可能比 max_seq_len 短
scores = scores + self.mask[:, :, :seqlen, :seqlen]
# 计算 softmax,维度为 (B, nh, T, T)
scores = F.softmax(scores.float(), dim=-1).type_as(xq)
# 做 Dropout
scores = self.attn_dropout(scores)
# V * Score,维度为(B, nh, T, T) x (B, nh, T, hs) -> (B, nh, T, hs)
output = torch.matmul(scores, xv)
# 恢复时间维度并合并头。
# 将多头的结果拼接起来, 先交换维度为 (B, T, n_head, dim // n_head),再拼接成 (B, T, n_head * dim // n_head)
# contiguous 函数用于重新开辟一块新内存存储,因为Pytorch设置先transpose再view会报错,
# 因为view直接基于底层存储得到,然而transpose并不会改变底层存储,因此需要额外存储
output = output.transpose(1, 2).contiguous().view(bsz, seqlen, -1)
# 最终投影回残差流。
output = self.wo(output)
output = self.resid_dropout(output)
return output
|
2.2 Encoder-Decoder#
Transformer框架的两个核心组件:
Encoder(编码器)和Decoder(解码器)
2.2.1 Seq2Seq模型#
Seq2Seq:序列到序列
具体而言,
是指模型输入的是一个自然语言序列 input=(x1,x2,x3…xn)inpu**t=(x1,x2,x3…x**n) ,输出的是一个可能不等长的自然语言序列 output=(y1,y2,y3…ym)output=(y1,y2,y3…y**m)
流程解析:
对于 Seq2Seq 任务,一般的思路是对自然语言序列进行编码再解码。所谓编码,就是将输入的自然语言序列通过隐藏层编码成能够表征语义的向量(或矩阵),可以简单理解为更复杂的词向量表示。而解码,就是对输入的自然语言序列编码得到的向量或矩阵通过隐藏层输出,再解码成对应的自然语言目标序列。通过编码再解码,就可以实现 Seq2Seq 任务。
而其中的编码和解码工作,就是有Encoder和Decoder完成的
Transformer的架构:
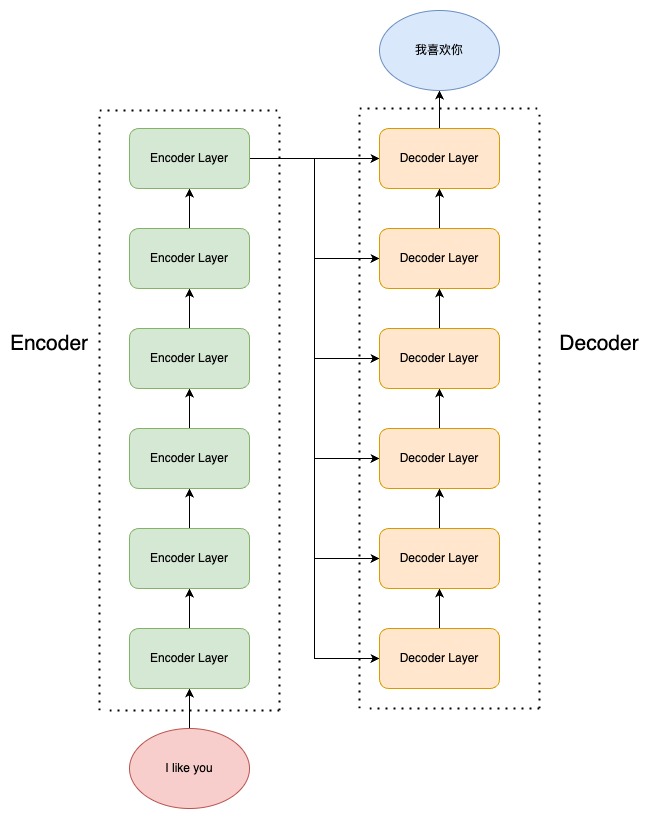
Transformer 由 Encoder 和 Decoder 组成,每一个 Encoder(Decoder)又由 6个 Encoder(Decoder)Layer 组成。输入源序列会进入 Encoder 进行编码,到 Encoder Layer 的最顶层再将编码结果输出给 Decoder Layer 的每一层,通过 Decoder 解码后就可以得到输出目标序列了
Encoder 和 Decoder 内部传统神经网络的经典结构——前馈神经网络(FNN)、层归一化(Layer Norm)和残差连接(Residual Connection)
2.2.2 前馈神经网络(FNN)#
每一层的神经元都和上下两层的每一个神经元完全连接的网络结构
每一个 Encoder Layer 都包含一个上文讲的注意力机制和一个前馈神经网络
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| class MLP(nn.Module):
'''前馈神经网络'''
def __init__(self, dim: int, hidden_dim: int, dropout: float):
super().__init__()
# 定义第一层线性变换,从输入维度到隐藏维度
self.w1 = nn.Linear(dim, hidden_dim, bias=False)
# 定义第二层线性变换,从隐藏维度到输入维度
self.w2 = nn.Linear(hidden_dim, dim, bias=False)
# 定义dropout层,用于防止过拟合
self.dropout = nn.Dropout(dropout)
def forward(self, x):
# 前向传播函数
# 首先,输入x通过第一层线性变换和RELU激活函数
# 最后,通过第二层线性变换和dropout层
return self.dropout(self.w2(F.relu(self.w1(x))))
|
Transformer的FNN的架构:
由两个线性层中间加一个 RELU 激活函数组成的,以及前馈神经网络还加入了一个 Dropout 层来防止过拟合
Dropout 层只在训练时开启,推理/测试阶段关闭
2.2.3 层归一化(Layer Norm)#
神经网络的主流归一化操作有:
批归一化(Batch Norm)和层归一化(Layer Norm)
归一化核心是为了让不同层输入的取值范围或者分布能够比较一致
误差的产生:
本层的输入为上一层的输出,随着参数的更新导致的输入(输出)分布发生改变和深度的加深,差异会越来越大,然而预测的条件分布始终是相同的,就造成了误差
因此需要归一化:归一化为标准正态分布
批归一化是指在一个 mini-batch 上进行归一化,相当于对一个 batch 对样本拆分出来一部分,首先计算样本的均值:
$$
μj=\frac{1}{m}\sum_{i=1}^{m}Z_{ji}
$$
其中,Zji 是样本 i 在第 j 个维度上的值,m 就是 mini-batch 的大小。
再计算样本的方差:
$$
σ2=\frac{1}{m}\sum_{i=1}^{m}(Z_{ji}-\mu_j)^2
$$
最后,对每个样本的值减去均值再除以标准差来将这一个 mini-batch 的样本的分布转化为标准正态分布:
$$
Z~j=\frac{Z_j-\mu_j}{\sqrt{\sigma^2+\epsilon}}
$$
此处加上 ϵ 这一极小量是为了避免分母为0。
但是批归一化存在缺陷.例如:
1.显存有限,mini-batch比较小,批归一化无法返回全局信息,效果比较差
2.对于在时间维度展开的 RNN,不同句子的同一分布大概率不同,所以 Batch Norm 的归一化会失去意义
3.在训练时,Batch Norm 需要保存每个 step 的统计信息(均值和方差)。在测试时,由于变长句子的特性,测试集可能出现比训练集更长的句子,所以对于后面位 置的 step,是没有训练的统计量使用的
4.应用 Batch Norm,每个 step 都需要去保存和计算 batch 统计量,耗时又耗力
因此出现了层归一化:
Layer Norm 的归一化方式其实和 Batch Norm 是完全一样的,只是统计统计量的维度不同
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
| class LayerNorm(nn.Module):
''' Layer Norm 层'''
def __init__(self, features, eps=1e-6):
super().__init__()
# 线性矩阵做映射
self.a_2 = nn.Parameter(torch.ones(features))
self.b_2 = nn.Parameter(torch.zeros(features))
self.eps = eps
def forward(self, x):
# 在统计每个样本所有维度的值,求均值和方差
mean = x.mean(-1, keepdim=True) # mean: [bsz, max_len, 1]
std = x.std(-1, keepdim=True) # std: [bsz, max_len, 1]
# 注意这里也在最后一个维度发生了广播
return self.a_2 * (x - mean) / (std + self.eps) + self.b_2
|
2.2.4 残差连接
为了避免模型退化,使用残差连接的思想来连接每一个子层:
即下一层的输入不仅是上一层的输出,还包括上一层的输入.允许最底层信息直接传到最高层,让高层专注残差的学习
例如:
在 Encoder 中,在第一个子层,输入会先进行层归一化(Layer Norm),然后进入多头自注意力层,其输出会与原输入相加。在第二个子层也是一样。
1
2
3
| x=x+MultiHeadSelfAttention(LayerNorm(x))
output=x+FNN(LayerNorm(x))
|
在代码实现中:
1
2
3
4
| # 注意力计算
h = x + self.attention.forward(self.attention_norm(x))
# 经过前馈神经网络
out = h + self.feed_forward.forward(self.fnn_norm(h))
|
在上文代码中,self.attention_norm 和 self.fnn_norm 都是 LayerNorm 层,self.attn 是注意力层,而 self.feed_forward 是前馈神经网络。
2.2.5 Encoder#
Encoder 由 N 个 Encoder Layer 组成,每一个 Encoder Layer 包括一个注意力层和一个前馈神经网络
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
| class EncoderLayer(nn.Module):
'''Encoder层'''
def __init__(self, args):
super().__init__()
# 一个 Layer 中有两个 LayerNorm,分别在 Attention 之前和 MLP 之前
self.attention_norm = LayerNorm(args.n_embd)
# Encoder 不需要掩码,传入 is_causal=False
self.attention = MultiHeadAttention(args, is_causal=False)
self.fnn_norm = LayerNorm(args.n_embd)
self.feed_forward = MLP(args.dim, args.dim, args.dropout)
def forward(self, x):
# Layer Norm
norm_x = self.attention_norm(x)
# 自注意力
h = x + self.attention.forward(norm_x, norm_x, norm_x)
# 经过前馈神经网络
out = h + self.feed_forward.forward(self.fnn_norm(h))
return out
|
然后我们搭建一个 Encoder,由 N 个 Encoder Layer 组成,在最后会加入一个 Layer Norm 实现规范化:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| class Encoder(nn.Module):
'''Encoder 块'''
def __init__(self, args):
super(Encoder, self).__init__()
# 一个 Encoder 由 N 个 Encoder Layer 组成
self.layers = nn.ModuleList([EncoderLayer(args) for _ in range(args.n_layer)])
self.norm = LayerNorm(args.n_embd)
def forward(self, x):
"分别通过 N 层 Encoder Layer"
for layer in self.layers:
x = layer(x)
return self.norm(x)
|
2.2.6 Decoder#
我们也可以先搭建 Decoder Layer,再将 N 个 Decoder Layer 组装为 Decoder
Decoder 由两个注意力层和一个前馈神经网络组成。第一个注意力层是一个掩码自注意力层,即使用 Mask 的注意力计算,保证每一个 token 只能使用该 token 之前的注意力分数;第二个注意力层是一个多头注意力层,该层将使用第一个注意力层的输出作为 query,使用 Encoder 的输出作为 key 和 value,来计算注意力分数。最后,再经过前馈神经网络:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
| class DecoderLayer(nn.Module):
'''解码层'''
def __init__(self, args):
super().__init__()
# 一个 Layer 中有三个 LayerNorm,分别在 Mask Attention 之前、Self Attention 之前和 MLP 之前
self.attention_norm_1 = LayerNorm(args.n_embd)
# Decoder 的第一个部分是 Mask Attention,传入 is_causal=True
self.mask_attention = MultiHeadAttention(args, is_causal=True)
self.attention_norm_2 = LayerNorm(args.n_embd)
# Decoder 的第二个部分是 类似于 Encoder 的 Attention,传入 is_causal=False
self.attention = MultiHeadAttention(args, is_causal=False)
self.ffn_norm = LayerNorm(args.n_embd)
# 第三个部分是 MLP
self.feed_forward = MLP(args.dim, args.dim, args.dropout)
def forward(self, x, enc_out):
# Layer Norm
norm_x = self.attention_norm_1(x)
# 掩码自注意力
x = x + self.mask_attention.forward(norm_x, norm_x, norm_x)
# 多头注意力
norm_x = self.attention_norm_2(x)
h = x + self.attention.forward(norm_x, enc_out, enc_out)
# 经过前馈神经网络
out = h + self.feed_forward.forward(self.ffn_norm(h))
return out
|
然后同样的,我们搭建一个 Decoder 块:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
| class Decoder(nn.Module):
'''解码器'''
def __init__(self, args):
super(Decoder, self).__init__()
# 一个 Decoder 由 N 个 Decoder Layer 组成
self.layers = nn.ModuleList([DecoderLayer(args) for _ in range(args.n_layer)])
self.norm = LayerNorm(args.n_embd)
def forward(self, x, enc_out):
"Pass the input (and mask) through each layer in turn."
for layer in self.layers:
x = layer(x, enc_out)
return self.norm(x)
|
2.3.1 Embedding层#
将自然语言转化为机器能够处理的向量
Embedding:存储固定大小的词典的嵌入向量查找表
在进入神经网络之前.自然语言输入通过tokenizer,将自然语言输入切分成token并且转化成一个固定的index
Embedding的输入:一个形状为 (batch_size,seq_len,1):
第一个维度是一次批处理的数量,第二个维度是自然语言序列的长度,第三个维度则是 token 经过 tokenizer 转化成的 index 值
而 Embedding 内部其实是一个可训练的(Vocab_size,embedding_dim)的权重矩阵,词表里的每一个值,都对应一行维度为 embedding_dim 的向量。对于输入的值,会对应到这个词向量,然后拼接成(batch_size,seq_len,embedding_dim)的矩阵输出。
1
| self.tok_embeddings = nn.Embedding(args.vocab_size, args.dim)
|
2.2.3 位置编码#
注意计算方式的缺陷:
导致序列中相对位置的丢失
例如:对于序列中的每一个 token,其他各个位置对其来说都是平等的,即“我喜欢你”和“你喜欢我”在注意力机制看来是完全相同的
解决方法:位置编码位置编码,即根据序列中 token 的相对位置对其进行编码,再将位置编码加入词向量编码中。位置编码的方式有很多,Transformer 使用了正余弦函数来进行位置编码(绝对位置编码Sinusoidal),其编码方式为:
$$
PE(pos,2i)=sin(pos/10000
2i/d
model
)
$$
$$
PE(pos,2i+1)=cos(pos/10000
2i/d
model
)
$$
上式中,pos 为 token 在句子中的位置,2i 和 2i+1 则指示了位置编码向量的维度索引是奇数还是偶数,从上式中我们可以看出对于奇数维度和偶数维度,Transformer 采用了不同的函数进行编码。
例子:
则经过位置编码后的词向量为:
xPE=[0.10.20.30.40.20.30.40.50.30.40.50.60.40.50.60.7]+[sin(0100000)cos(0100000)sin(0100002/4)cos(0100002/4)sin(1100000)cos(1100000)sin(1100002/4)cos(1100002/4)sin(2100000)cos(2100000)sin(2100002/4)cos(2100002/4)sin(3100000)cos(3100000)sin(3100002/4)cos(3100002/4)]=[0.11.20.31.41.0410.840.411.491.209−0.0160.521.590.541−0.4890.8951.655]xPE=0.10.20.30.40.20.30.40.50.30.40.50.60.40.50.60.7+sin(1000000)sin(1000001)sin(1000002)sin(1000003)cos(1000000)cos(1000001)cos(1000002)cos(1000003)sin(100002/40)sin(100002/41)sin(100002/42)sin(100002/43)cos(100002/40)cos(100002/41)cos(100002/42)cos(100002/43)=0.11.0411.2090.5411.20.84−0.016−0.4890.30.410.520.8951.41.491.591.655
我们可以使用如下的代码来获取上述例子的位置编码:
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
| import numpy as np
import matplotlib.pyplot as plt
def PositionEncoding(seq_len, d_model, n=10000):
P = np.zeros((seq_len, d_model))
for k in range(seq_len):
for i in np.arange(int(d_model/2)):
denominator = np.power(n, 2*i/d_model)
P[k, 2*i] = np.sin(k/denominator)
P[k, 2*i+1] = np.cos(k/denominator)
return P
P = PositionEncoding(seq_len=4, d_model=4, n=100)
print(P)Copy to clipboardErrorCopied
[[ 0. 1. 0. 1. ]
[ 0.84147098 0.54030231 0.09983342 0.99500417]
[ 0.90929743 -0.41614684 0.19866933 0.98006658]
[ 0.14112001 -0.9899925 0.29552021 0.95533649]]
|
这样的位置编码主要有两个好处:
- 使 PE 能够适应比训练集里面所有句子更长的句子,假设训练集里面最长的句子是有 20 个单词,突然来了一个长度为 21 的句子,则使用公式计算的方法可以计算出第 21 位的 Embedding。
- 可以让模型容易地计算出相对位置,对于固定长度的间距 k,PE(pos+k) 可以用 PE(pos) 计算得到。因为 Sin(A+B) = Sin(A)Cos(B) + Cos(A)Sin(B), Cos(A+B) = Cos(A)Cos(B) - Sin(A)Sin(B)。
上面那个好复杂,还是代码看着顺眼
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
| class PositionalEncoding(nn.Module):
'''位置编码模块'''
def __init__(self, args):
super(PositionalEncoding, self).__init__()
# Dropout 层
# self.dropout = nn.Dropout(p=args.dropout)
# block size 是序列的最大长度
pe = torch.zeros(args.block_size, args.n_embd)
position = torch.arange(0, args.block_size).unsqueeze(1)
# 计算 theta
div_term = torch.exp(
torch.arange(0, args.n_embd, 2) * -(math.log(10000.0) / args.n_embd)
)
# 分别计算 sin、cos 结果
pe[:, 0::2] = torch.sin(position * div_term)
pe[:, 1::2] = torch.cos(position * div_term)
pe = pe.unsqueeze(0)
self.register_buffer("pe", pe)
def forward(self, x):
# 将位置编码加到 Embedding 结果上
x = x + self.pe[:, : x.size(1)].requires_grad_(False)
return x
|
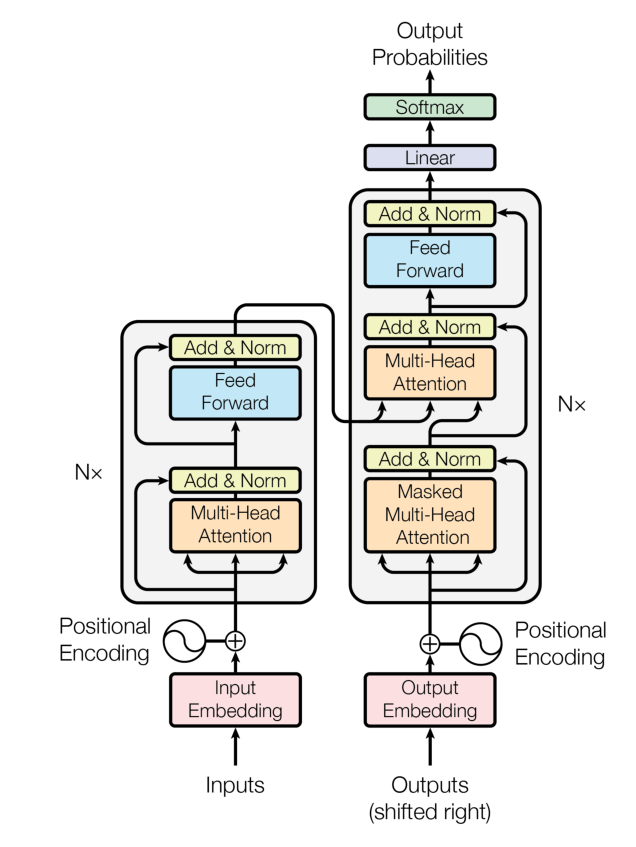
但需要注意的是,上图是原论文《Attention is all you need》配图,LayerNorm 层放在了 Attention 层后面,也就是“Post-Norm”结构,但在其发布的源代码中,LayerNorm 层是放在 Attention 层前面的,也就是“Pre Norm”结构。考虑到目前 LLM 一般采用“Pre-Norm”结构(可以使 loss 更稳定),本文在实现时采用“Pre-Norm”结构。
如图,经过 tokenizer 映射后的输出先经过 Embedding 层和 Positional Embedding 层编码,然后进入上一节讲过的 N 个 Encoder 和 N 个 Decoder(在 Transformer 原模型中,N 取为6),最后经过一个线性层和一个 Softmax 层就得到了最终输出。
 1
 2
 3
 4
 5
 6
 7
 8
 9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
| class Transformer(nn.Module):
'''整体模型'''
def __init__(self, args):
super().__init__()
# 必须输入词表大小和 block size
assert args.vocab_size is not None
assert args.block_size is not None
self.args = args
self.transformer = nn.ModuleDict(dict(
wte = nn.Embedding(args.vocab_size, args.n_embd),
wpe = PositionalEncoding(args),
drop = nn.Dropout(args.dropout),
encoder = Encoder(args),
decoder = Decoder(args),
))
# 最后的线性层,输入是 n_embd,输出是词表大小
self.lm_head = nn.Linear(args.n_embd, args.vocab_size, bias=False)
# 初始化所有的权重
self.apply(self._init_weights)
# 查看所有参数的数量
print("number of parameters: %.2fM" % (self.get_num_params()/1e6,))
'''统计所有参数的数量'''
def get_num_params(self, non_embedding=False):
# non_embedding: 是否统计 embedding 的参数
n_params = sum(p.numel() for p in self.parameters())
# 如果不统计 embedding 的参数,就减去
if non_embedding:
n_params -= self.transformer.wte.weight.numel()
return n_params
'''初始化权重'''
def _init_weights(self, module):
# 线性层和 Embedding 层初始化为正则分布
if isinstance(module, nn.Linear):
torch.nn.init.normal_(module.weight, mean=0.0, std=0.02)
if module.bias is not None:
torch.nn.init.zeros_(module.bias)
elif isinstance(module, nn.Embedding):
torch.nn.init.normal_(module.weight, mean=0.0, std=0.02)
'''前向计算函数'''
def forward(self, idx, targets=None):
# 输入为 idx,维度为 (batch size, sequence length, 1);targets 为目标序列,用于计算 loss
device = idx.device
b, t = idx.size()
assert t <= self.args.block_size, f"不能计算该序列,该序列长度为 {t}, 最大序列长度只有 {self.args.block_size}"
# 通过 self.transformer
# 首先将输入 idx 通过 Embedding 层,得到维度为 (batch size, sequence length, n_embd)
print("idx",idx.size())
# 通过 Embedding 层
tok_emb = self.transformer.wte(idx)
print("tok_emb",tok_emb.size())
# 然后通过位置编码
pos_emb = self.transformer.wpe(tok_emb)
# 再进行 Dropout
x = self.transformer.drop(pos_emb)
# 然后通过 Encoder
print("x after wpe:",x.size())
enc_out = self.transformer.encoder(x)
print("enc_out:",enc_out.size())
# 再通过 Decoder
x = self.transformer.decoder(x, enc_out)
print("x after decoder:",x.size())
if targets is not None:
# 训练阶段,如果我们给了 targets,就计算 loss
# 先通过最后的 Linear 层,得到维度为 (batch size, sequence length, vocab size)
logits = self.lm_head(x)
# 再跟 targets 计算交叉熵
loss = F.cross_entropy(logits.view(-1, logits.size(-1)), targets.view(-1), ignore_index=-1)
else:
# 推理阶段,我们只需要 logits,loss 为 None
# 取 -1 是只取序列中的最后一个作为输出
logits = self.lm_head(x[:, [-1], :]) # note: using list [-1] to preserve the time dim
loss = None
return logits, loss
|
在前向计算函数中,我们对模型使用 pytorch 的交叉熵函数来计算损失