第三章 预训练语言模型(PLM)
3.1 Encoder-only PLM
3.1.1 BERT( Bidirectional Encoder Representations from Transformers)
由Google发布的,引领了预训练+微调的的潮流
(1)思想沿承
统一了多种思想的预训练框架,包括: Transformer架构: 通过在Transformer的模型基座上进行优化,将Encoder的结构进行堆叠,扩大模型参数 预训练+微调范式: ELMo模型基于LSTM双向架构 而BERT则将模型框架调整为了Transformer,引入了更适合文本理解,能捕捉深层双向语义的预训练任务MLM
接下来从模型架构,预训练任务,下游任务来深入剖析BERT
(2)模型架构
采取了将Transformer的Encoder部分堆叠而成
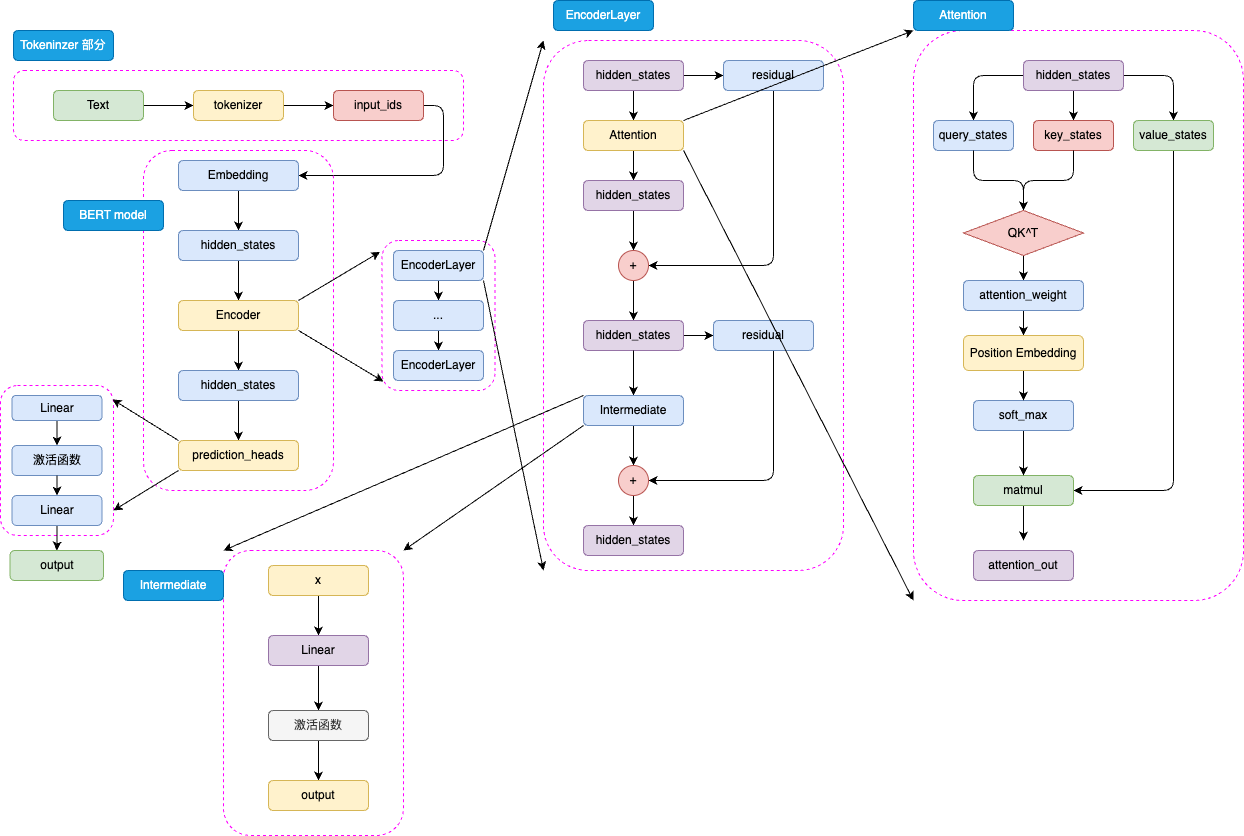
其输入一般是文本序列,输出一般是Label
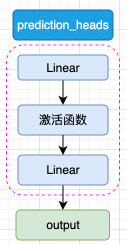
分类头:predictions_heads: 将多维度的隐藏状态从线性层转化到分类维度
模型整体上是由Embedding,Encoder,prediction_heads组成的
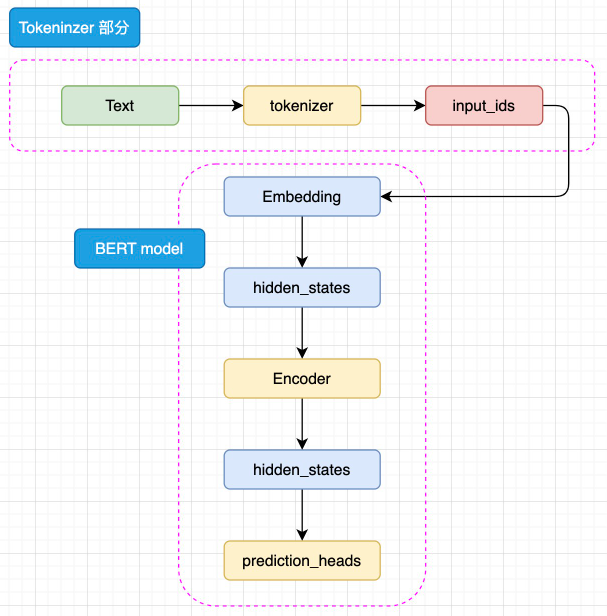
输入文本->tokenizer->input_ids->Embedding->hidden_states->Encoder->最顶层hidden_states->predictions_heads 其中Encoder块中,BERT由有两种规模的模型,分别是: base版本:12层Encoder layer 768的隐藏层维度 总参数量110M lager版本:24层Encoder layer 1024隐藏层维度从总参数数量340M
BERT的分词方法: WordPiece 基于统计的子词切分算法,核心在于把单词拆解为子词,其合并操作的依据所示最大化语言模型的似然度,对于中文等非空格分割的语言通常采用单个汉字作为token处理
prediction_heads其实就是线性层加上激活函数
而每一层Encoder layer都是和Transformer中的Encoder结构相似的层 图片描述
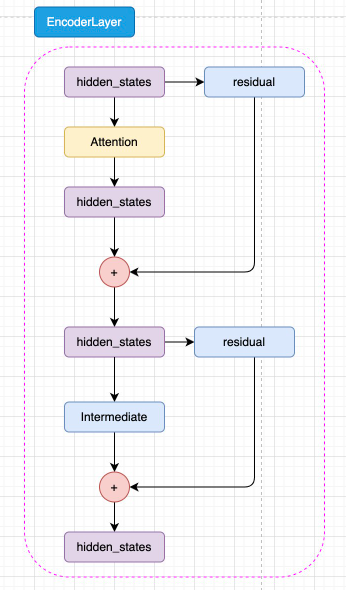
通过 Embedding 层映射的 hidden_states 进入核心的 attention 机制,然后通过残差连接的机制和原输入相加,再经过一层 Intermediate 层得到最终输出
采用的激活函数:GELU函数,全名为高斯误差线性单元激活函数 起计算方式为: $$ GELU(x)=0.5x(1+tanh( π/ 2
)(x+0.044715x 3 )) $$ 核心思路L将随机正则的思想引入激活函数,通过输入自身的概率分布,来决定抛弃还是保留自己的神经元
BERT的注意力机制和Transformer几乎完全一致,但是BERT的相对位置编码融合在了记忆力机制中,将相对位置编码同样是为可以训练的权重参数 图片描述
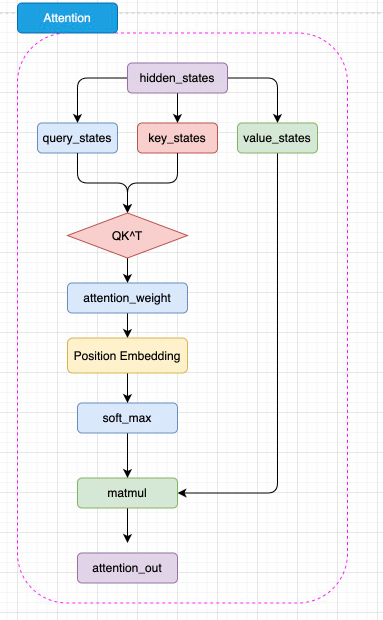
BERT 的注意力计算过程和 Transformer 的唯一差异在于,在完成注意力分数的计算之后,先通过 Position Embedding 层来融入相对位置信息。这里的 Position Embedding 层,其实就是一层线性矩阵。通过可训练的参数来拟合相对位置,相对而言比 Transformer 使用的绝对位置编码 Sinusoidal 能够拟合更丰富的相对位置信息,但是,这样也增加了不少模型参数,同时完全无法处理超过模型训练长度的输入 注解:最开始BERT采用的也是类似于Transformer的绝对位置编码,后续改进为相对位置编码
(3)预训练任务–MLM+NSP
创新点出现了!:新的两个预训练任务MLM+NSP(Next Sentence Prediction,下一句预测) 预训练+微调的范式的优越性在于: 完成预训练的模型可以仅通过微调应用在所有的下游任务当中 因此:可以进一步扩大模型参数和预训练数据量让模型拟合潜在语义和底层知识
预训练数据的核心要求是需要极大的数据规模.通过人工标注产出的全监督数据很难达到这个规模。因此,预训练数据一定是从无监督的语料中获取
这也是为什么传统的预训练任务都是 LM 的原因——LM 使用上文预测下文的方式可以直接应用到任何文本中,对于任意文本,我们只需要将下文遮蔽将上文输入模型要求其预测就可以实现 LM 训练,因此互联网上所有文本语料都可以被用于预训练
LM预训练任务的缺陷: 直接拟合从左到右的语义关系.而忽略了双向的语音关系哦
因此,引入了MLM,第一个M的含义是MASK(掩码) 其思路为:在文本序列中随机遮蔽部分token,将没有被遮蔽的token输入模型中,要求模型根据输入预测被遮蔽的token. 可以同时利用上文和下文一起理解语义来预测被遮蔽的token
MLM的固有缺陷:
训练和下游任务应该是保持一致的,但是MLM不同,下游任务微调和推理的时候,是不存在我们人工加入
MLM的策略改进:(我去真的好聪明) 选择训练语料中的15%进行遮蔽,其中并不是全部都进行遮蔽,其中 80%进行遮蔽:进行MASK训练 10%被替换为任意一个token:让模型无法确定需要预测的token,从而保持每一个 token的上下文表征分布 10%保持不变:消除预训练和微调的不一致 且由于10%随机替换的概率很低,并不会影响模型实质语言理解能力
NSP: 核心思想是针对句级的NLU任务
自然语言推理是指,输入一个前提和一个推理,判断推理是否是符合前提的。这样的任务都需要模型在句级去拟合关系,判断两个句子之间的关系,而不仅是 MLM 在 token 级拟合的语义关系
NSP的核心思路是要求模型判断一个句对的两个句子是否是连续的上下文.例如:
| |
通过要求模型判断句对关系,迫使模型拟合句子之间的关系,来适配句级的NLU任务 正样本可以从无监督语料中抽取连续的句子,负样本对句子打乱后随机抽取,因此可以拥有几乎无限的训练数据
(4)下游任务微调
预训练-微调的重点在于: 通过预训练获得的强大能力是否通过低成本的微调快速迁移到对应的下游任务中
策略: 设计了更加通用的输入和输出层来设配多任务下的迁移学习: 对于每一个输入的文本序列,会在首部加入一个特殊的token代表整句的状态,也就是句级的语义特征.在进行NSP预训练时,就使用该token对应的特征向量来作为最后分类器的输入
在完成预训练后,针对每一个下游任务,只需要使用一定量的全监督人工标注数据,对预训练的 BERT 在该任务上进行微调即可。
对于某些特定、训练数据丰富且强调高吞吐的任务,BERT 比 LLM 更具有可用性
3.1.2 RoBERTa
经过BERT优化而来的
(1)优化一: 去掉NSP预训练任务
RoBERTa使用BERT的lager框架 实验结果表明:NSP 任务并不能提高模型性能,因为其太过简单,加入到预训练中并不能使下游任务微调时明显受益,甚至会带来负面效果。
对于MLM任务的优化:
动态遮蔽策略:
RoBERTa 对 MLM 任务本身也做出了改进。在 BERT 中,Mask 的操作是在数据处理的阶段完成的,因此后期预训练时同一个 sample 待预测的 <MASK> 总是一致的。由于 BERT 共训练了 40 个 Epoch,为使模型的训练数据更加广泛,BERT 将数据进行了四次随机 Mask,也就是每 10个 Epoch 模型训练的数据是完全一致的。而 RoBERTa 将 Mask 操作放到了训练阶段,也就是动态遮蔽策略,从而让每一个 Epoch 的训练数据 Mask 的位置都不一致。
训练效果优势不明显,但是高效且易于实现,后续更多都采用动态遮蔽
(2)优化二: 更大的bpe词表
Tokenizer的编码策略不同:使用了BPE的编码策略, 即Byte Pair Encoding 字节对编码,以子词对作为分词的单位,例如: 对“Hello World”这句话,可能会切分为“Hel,lo,Wor,ld”四个子词对。而对于以字为基本单位的中文,一般会按照字节编码进行切分。例如,在 UTF-8 编码中,“我”会被编码为“E68891”,那么在 BPE 中可能就会切分成“E68”,“891”两个字词对
BPE编码的词典越大,编码效果越好,在Embedding将其映射到隐藏空间的时候,也会带来模型参数的增加
它的成功证明了更大的预训练数据和更大的预训练补偿的重要意义,这也是LLM诞生的基础之一
3.1.3 ALBERT
优化角度:减小模型参数同时保持模型能力 改进角度:对模型结构进行优化并且对NSP预训练任务进行了改进->SOP
(1)优化一:将Embedding参数进行分解
一个方面:参数太大会造成极大的模型计算开销 零一个方面:从Word2Vec的成功来看,此项两并不需要很大的维度 优化方式: 在Embedding层的输出维度和隐藏层解绑,在中间加入一个线性矩阵进行维度变换 参数变化:Embedding的参数从V×H变化到V×E + E×H
(2)优化二:跨层进行参数共享
通过共享参数降低模型的参数,同时可以极大程度地扩大隐藏层维度 实际上:ALNERT仅初始化一个Encoder层,24次运算均经过这一个Encoder层,可以实现一个更宽但是参数量更小地模型
缺陷:训练效率仅略优于BERT,且推理速度还要更慢
(3)优化三: 提出了SOP预训练任务
认为NSP过于简单,于是改进为SOP预训练 SOP任务的改进:
正例:由两个连续句子组成 负例:将这两个句子的顺序反过来 迫使学习句子的拟合关系和顺序关系
eg:
| |
很多模型都是在BERT的架构上进行优化
3.2 Encoder-Decoder PLM
3.2.1 T5
T5(Text-To-Text Transfer Transformer) 基本架构: T5 基于 Transformer 架构,包含编码器和解码器两个部分,使用自注意力机制和多头注意力捕捉全局依赖关系,利用相对位置编码处理长序列中的位置信息,并在每层中包含前馈神经网络进一步处理特征 T5 的大一统思想将不同的 NLP 任务如文本分类、问答、翻译等统一表示为输入文本到输出文本的转换 优点: 这种方法简化了模型设计、参数共享和训练过程,提高了模型的泛化能力和效率。通过这种统一处理方式,T5不仅减少了任务特定的模型调试工作,还能够使用相同的数据处理和训练框架,极大地提升了多任务学习的性能和应用的便捷性
(1)模型结构: Encoder-Decoder
编码器用于处理输入文本,解码器用于生成输出文本,两者之间通过注意力机制进行信息交互 主要结构如图: 图片描述
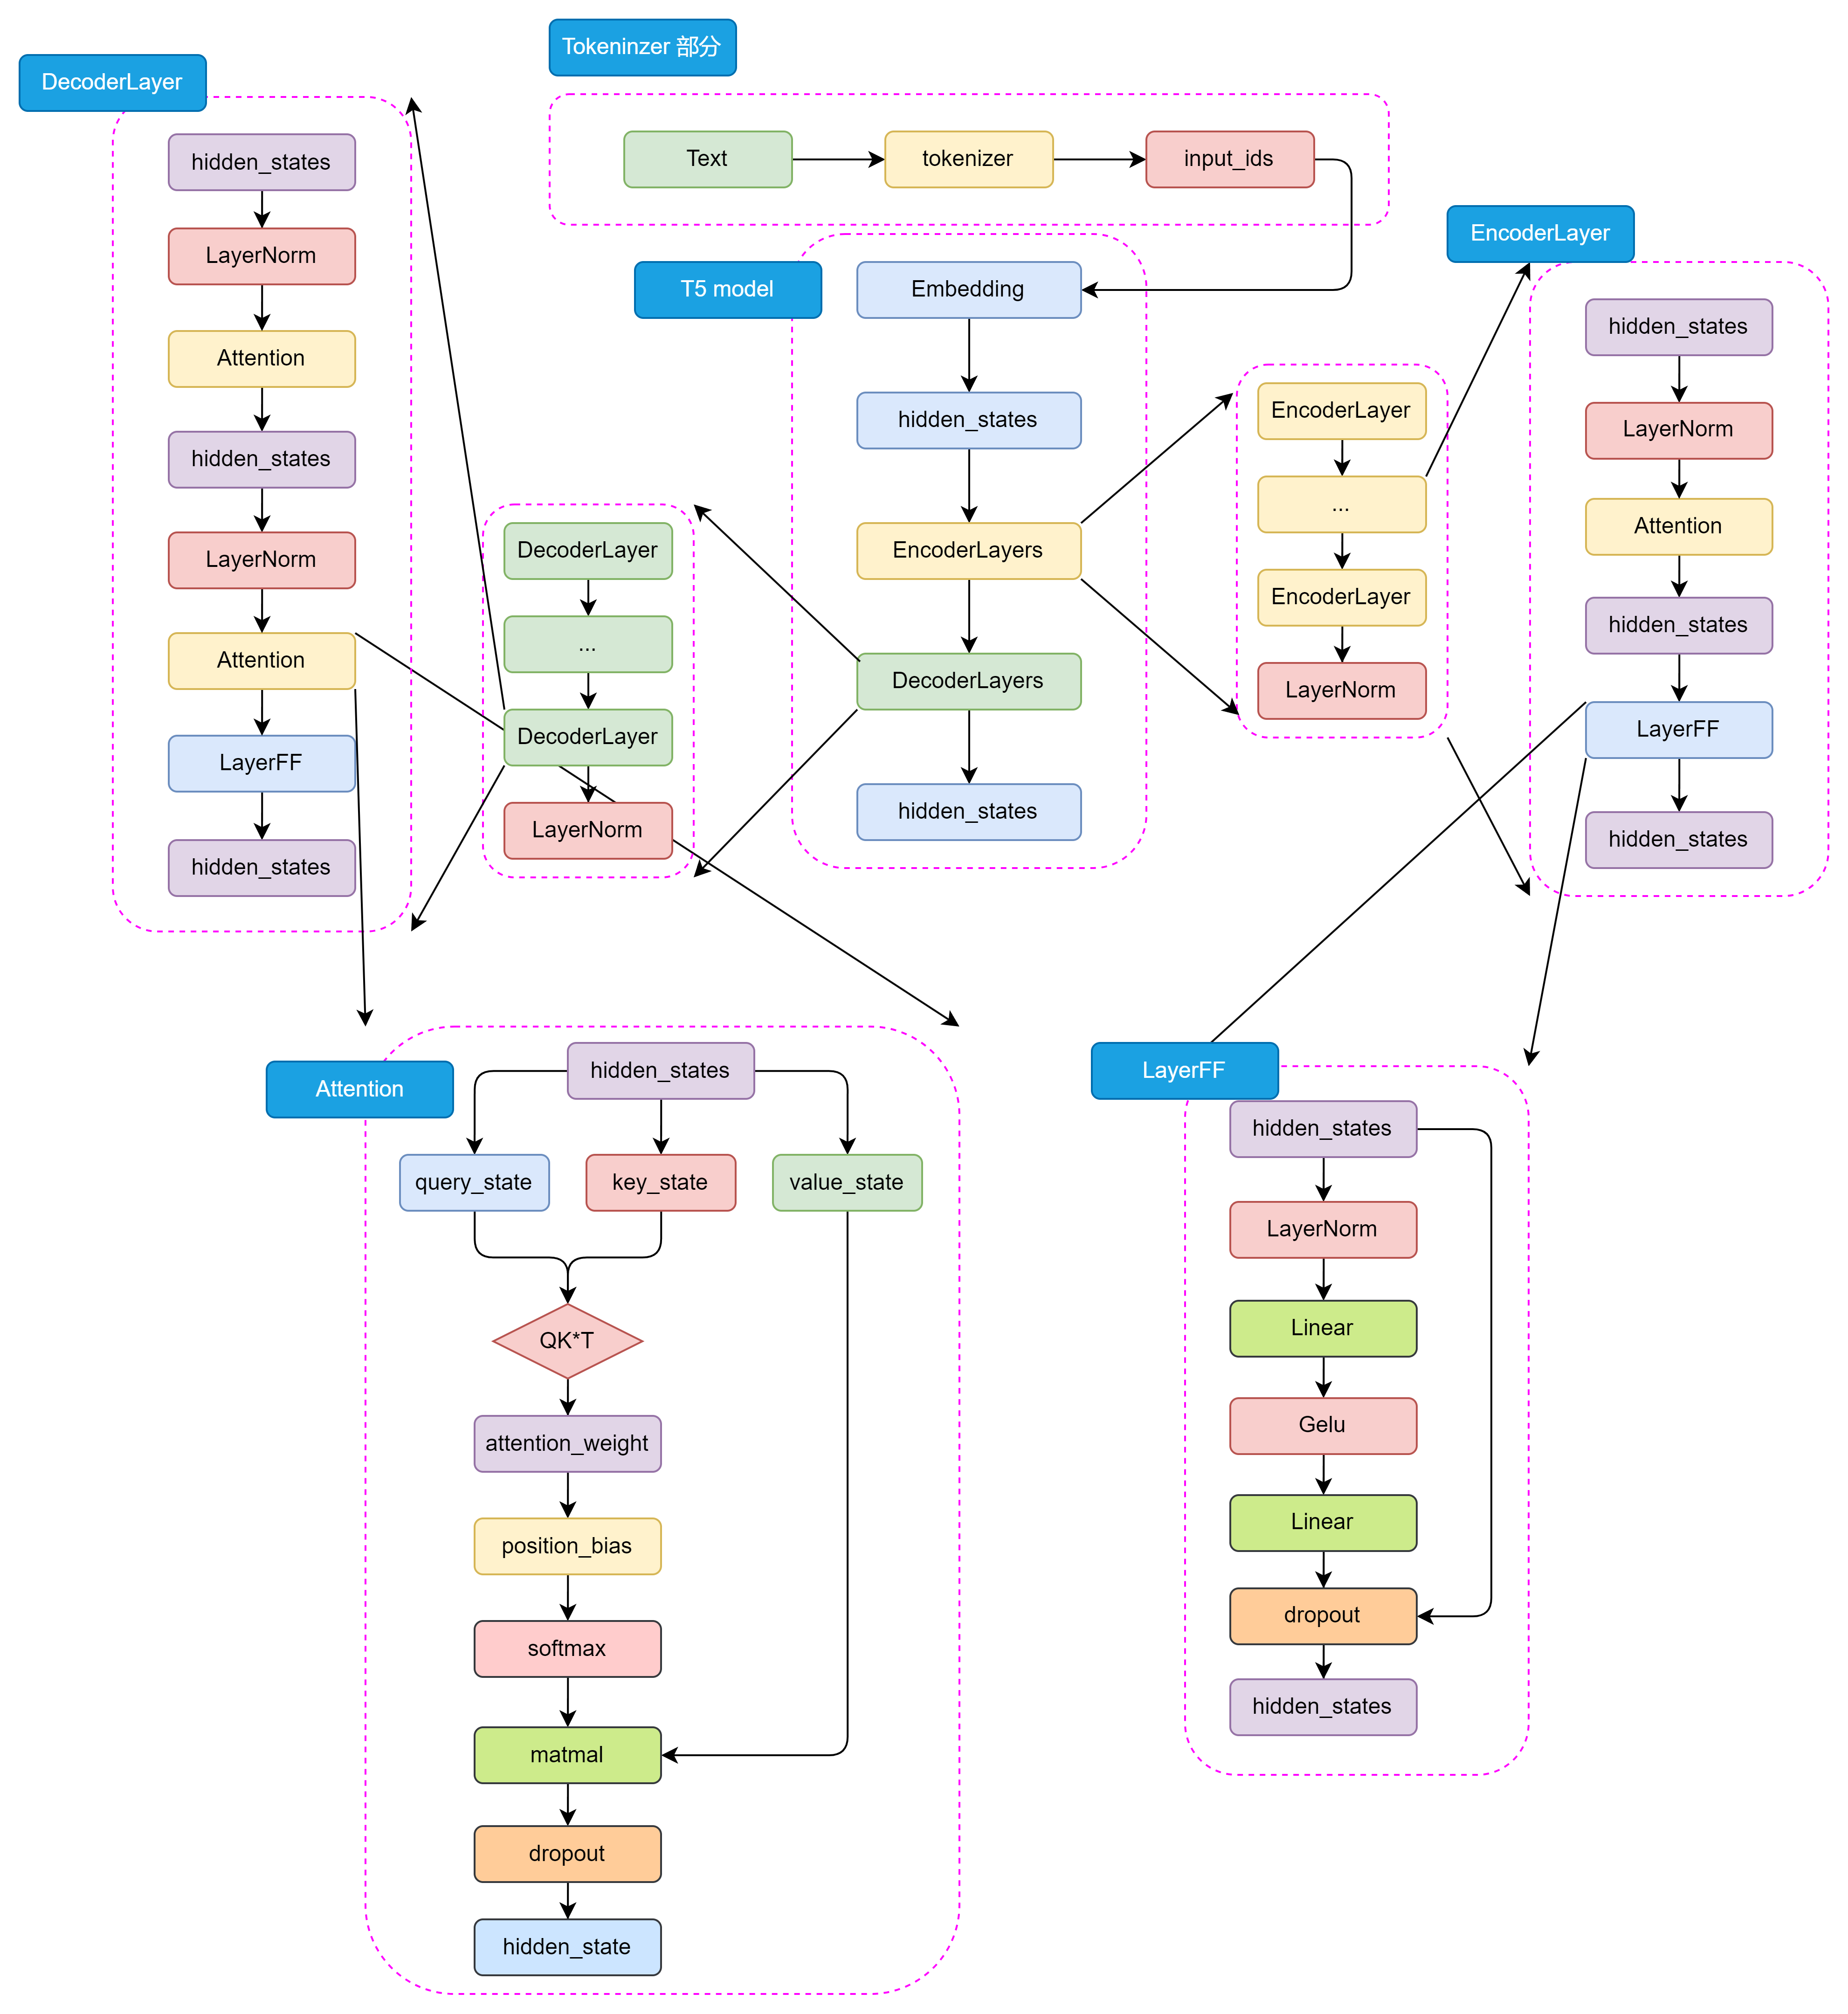
从整体来看 T5 的模型结构包括 Tokenizer 部分和 Transformer 部分。Tokenizer 部分主要负责将输入文本转换为模型可接受的输入格式,包括分词、编码等操作。Transformer 部分又分为 EncoderLayers 和 DecoderLayers 两部分,他们分别由一个个小的 Block组成,每个 Block 包含了多头注意力机制、前馈神经网络和 Norm 层。
T5 模型的 Encoder 和 Decoder 部分都是基于 Transformer 架构设计的 Encoder-Decoder Attention 仅仅在位置编码和 Mask 机制上有所不同,主要是为了区分输入和输出序列。
于原始Transformer不同的,T5的LayerNorm采用了RMSNorm,计算每一个神经元的均方根来归一化每个隐藏层的激活值 优点:更简单,只有一个可学参数,可以更好地适应不同地任务和数据集 RMS函数可以用下面地数学公式表示: $$ $$ \mathrm{RMSNorm}(x) = \frac{x}{\sqrt{\frac{1}{n}\sum_{i=1}^{n}x_i^2 + \epsilon}} \cdot \gamma $$ $$ 其中:
- xi 是输入向量的第 i 个元素
- γ* 是可学习的缩放参数
- n*n 是输入向量的维度数量
- ϵ* 是一个小常数,用于数值稳定性(以避免除以零的情况)
(2)预训练任务
训练所使用的数据集是一个大规模的文本数据集,包含了各种各样的文本数据,如维基百科、新闻、书籍等等。对数据经过细致的处理后,生成了用于训练的750GB 的数据集 C4,且已在 TensorflowData 中开源
T5的预训练过程如下: 预训练任务:MLM,也成为BERT-style目标:在输入文本中随机遮蔽15%的token 输入格式:将将输入文本替换为"从文本到文本"格式 对于一个给定的文本序列:随机选择一些token进行遮蔽,用特殊占位符替换,被遮蔽的token序列作为输出目标 预训练数据集:C4:提取了大量干净的英语文本,经过了一定程度的清洗,去除了无意义的文本,重复的文本 多任务预训练:尝试将多个任务混合在一起进行预训练 预训练到微调的转换:微调在特定的数据集上进行训练并且根据任务调整编码策略
(3) 大一统思想
所有的NLP任务都可以统一为文本到文本的任务 其设计理念:将不同类型的NLP任务都转化统一的格式:输入和输出都是文本
对于不同的NLP任务,每次输入前都会加上一个任务描述前缀,明确指定当前任务的类型。这不仅帮助模型在预训练阶段学习到不同任务之间的通用特征,也便于在微调阶段迅速适应具体任务
3.3 Decoder-only PLM
目前LLM的基础框架(除了RWKV,Mamba等非Transformer框架除外) 而目前作为开源 LLM 基本架构的 LLaMA 模型,也正是在 GPT 的模型架构基础上优化发展而来
3.3.1 GPT(Generative Pre-Training Language Model)
GPT的传奇故事:上市了的O/还是那个O/吗? GPT,即 Generative Pre-Training Language Model,是由 OpenAI 团队于 2018年发布的预训练语言模型。虽然学界普遍认可 BERT 作为预训练语言模型时代的代表,但首先明确提出预训练-微调思想的模型其实是 GPT。GPT 提出了通用预训练的概念,也就是在海量无监督语料上预训练,进而在每个特定任务上进行微调,从而实现这些任务的巨大收益。虽然在发布之初,由于性能略输于不久后发布的 BERT,没能取得轰动性成果,也没能让 GPT 所使用的 Decoder-Only 架构成为学界研究的主流,但 OpenAI 团队坚定地选择了不断扩大预训练数据、增加模型参数,在 GPT 架构上不断优化,最终在 2020年发布的 GPT-3 成就了 LLM 时代的基础,并以 GPT-3 为基座模型的 ChatGPT 成功打开新时代的大门,成为 LLM 时代的最强竞争者也是目前的最大赢家。
(1)模型架构–Decoder Only
如图:
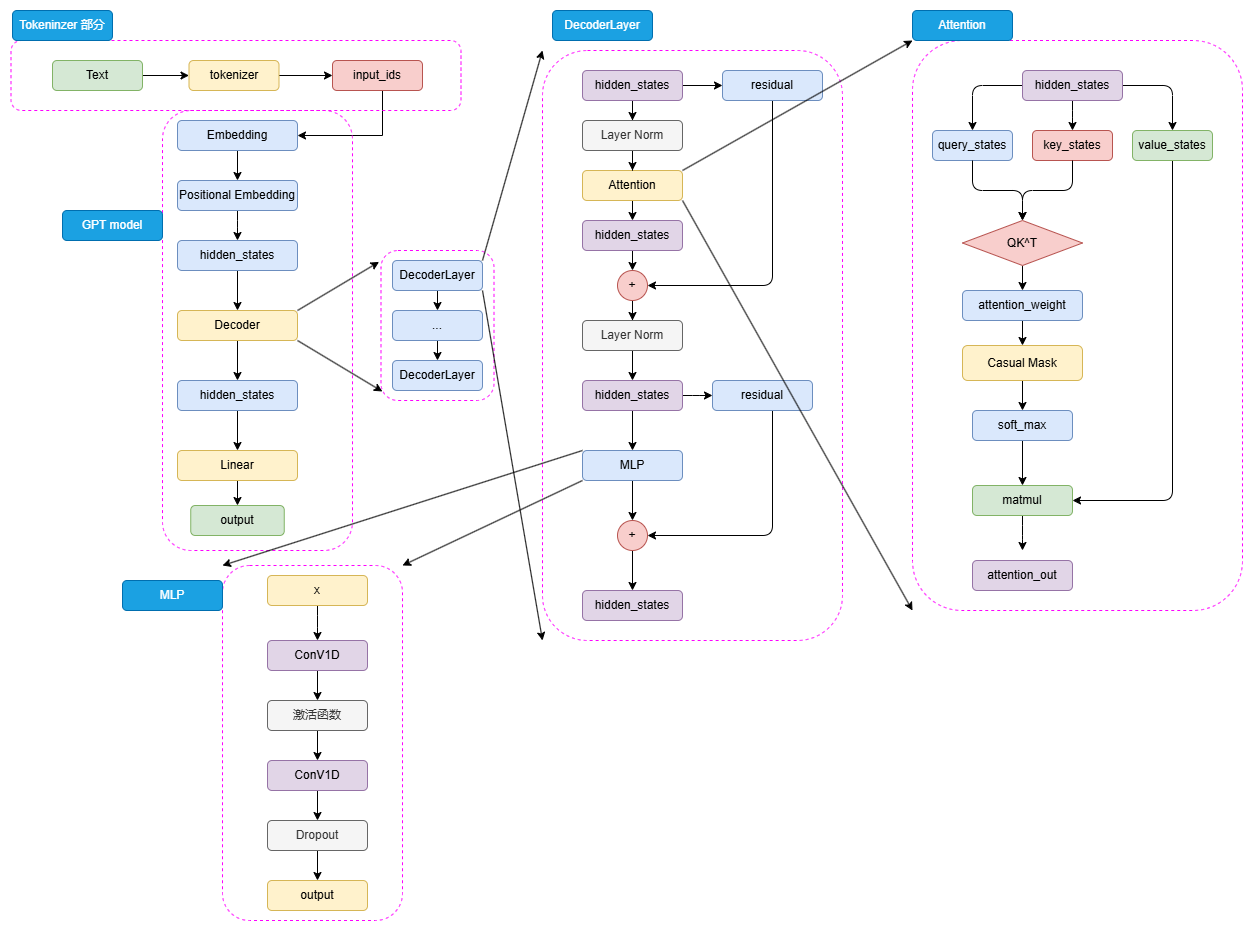
选择Decoder进行模型框架的堆叠,也天生更适用于文本生成任务 更加契合NLG任务和Seq2Seq任务 过程: 自然语言输入->tokenizer->inputs_ids->
| |
(2)预训练任务–CLM(因果语言模型)
Decoder-Only的结构更适合文本生成任务,所以其预训练任务也是最传统也最直接的预训练任务–因果语言模型,Causal Language Model,下简称 CLM CLM 可以看作 N-gram 语言模型的一个直接扩展。N-gram 语言模型是基于前 N 个 token 来预测下一个 token,CLM 则是基于一个自然语言序列的前面所有 token 来预测下一个 token,通过不断重复该过程来实现目标文本序列的生成。也就是说,CLM 是一个经典的补全形式
| |
BERT 之所以可以采用预训练+微调的范式取得重大突破,正是因为其选择的 MLM、NSP 可以在海量无监督语料上直接训练——而很明显,CLM 是更直接的预训练任务,其天生和人类书写自然语言文本的习惯相契合,也和下游任务直接匹配,相对于 MLM 任务更加直接,可以在任何自然语言文本上直接应用。因此,CLM 也可以使用海量的自然语言语料进行大规模的预训练
(3)GPT系列模型的发展
自 GPT-1 推出开始,OpenAI 一直坚信 Decoder-Only 的模型结构和“体量即正义”的优化思路,不断扩大预训练数据集、模型体量并对模型做出一些小的优化和修正,来不断探索更强大的预训练模型。从被 BERT 压制的 GPT-1,到没有引起足够关注的 GPT-2,再到激发了涌现能力、带来大模型时代的 GPT-3,最后带来了跨时代的 ChatGPT,OpenAI 通过数十年的努力证明了其思路的正确性。
下表总结了从 GPT-1 到 GPT-3 的模型结构、预训练语料大小的变化:
| 模型 | Decoder Layer | Hidden_size | 注意力头数 | 注意力维度 | 总参数量 | 预训练语料 |
|---|---|---|---|---|---|---|
| GPT-1 | 12 | 3072 | 12 | 768 | 0.12B | 5GB |
| GPT-2 | 48 | 6400 | 25 | 1600 | 1.5B | 40GB |
| GPT-3 | 96 | 49152 | 96 | 12288 | 175B | 570GB |
GPT-1 是 GPT 系列的开山之作,也是第一个使用 Decoder-Only 的预训练模型。但是,GPT-1 的模型体量和预训练数据都较少,沿承了传统 Transformer 的模型结构,使用了 12层 Decoder Block 和 768 的隐藏层维度,模型参数量仅有 1.17亿(0.12B),在大小为 5GB 的 BooksCorpus 数据集上预训练得到。可以看到,GPT-1 的参数规模与预训练规模和 BERT-base 是大致相当的,但其表现相较于 BERT-base 却有所不如,这也是 GPT 系列模型没能成为预训练语言模型时代的代表的原因。
GPT-2 则是 OpenAI 在 GPT-1 的基础上进一步探究预训练语言模型多任务学习能力的产物。GPT-2 的模型结构和 GPT-1 大致相当,只是扩大了模型参数规模、将 Post-Norm 改为了 Pre-Norm(也就是先进行 LayerNorm 计算,再进入注意力层计算)。这些改动的核心原因在于,由于模型层数增加、体量增大,梯度消失和爆炸的风险也不断增加,为了使模型梯度更稳定对上述结构进行了优化。
GPT-2 的核心改进是大幅增加了预训练数据集和模型体量。GPT-2 的 Decoder Block 层数达到了48(注意,GPT-2 共发布了四种规格的模型,此处我们仅指规格最大的 GPT-2 模型),隐藏层维度达到了 1600,模型整体参数量达 15亿(1.5B),使用了自己抓取的 40GB 大小的 WebText 数据集进行预训练,不管是模型结构还是预训练大小都超过了 1代一个数量级。
GPT-2 的另一个重大突破是以 zero-shot(零样本学习)为主要目标,也就是不对模型进行微调,直接要求模型解决任务。例如,在传统的预训练-微调范式中,我们要解决一个问题,一般需要收集几百上千的训练样本,在这些训练样本上微调预训练语言模型来实现该问题的解决。而 zero-shot 则强调不使用任何训练样本,直接通过向预训练语言模型描述问题来去解决该问题。zero-shot 的思路自然是比预训练-微调范式更进一步、更高效的自然语言范式,但是在 GPT-2 的时代,模型能力还不足够支撑较好的 zero-shot 效果,在大模型时代,zero-shot 及其延伸出的 few-shot(少样本学习)才开始逐渐成为主流。
GPT-3 则是更进一步展示了 OpenAI“力大砖飞”的核心思路,也是 LLM 的开创之作。在 GPT-2 的基础上,OpenAI 进一步增大了模型体量和预训练数据量,整体参数量达 175B,是当之无愧的“大型语言模型”。在模型结构上,基本没有大的改进,只是由于巨大的模型体量使用了稀疏注意力机制来取代传统的注意力机制。在预训练数据上,则是分别从 CC、WebText、维基百科等大型语料集中采样,共采样了 45T、清洗后 570GB 的数据。根据推算,GPT-3 需要在 1024张 A100(80GB 显存)的分布式训练集群上训练 1个月。
之所以说 GPT-3 是 LLM 的开创之作,除去其巨大的体量带来了涌现能力的凸显外,还在于其提出了 few-shot 的重要思想。few-shot 是在 zero-shot 上的改进,研究者发现即使是 175B 大小的 GPT-3,想要在 zero-shot 上取得较好的表现仍然是一件较为困难的事情。而 few-shot 是对 zero-shot 的一个折中,旨在提供给模型少样的示例来教会它完成任务。few-shot 一般会在 prompt(也就是模型的输入)中增加 3~5个示例,来帮助模型理解。例如,对于情感分类任务:
| |
通过给模型提供少量示例,模型可以取得远好于 zero-shot 的良好表现。few-shot 也被称为上下文学习(In-context Learning),即让模型从提供的上下文中的示例里学习问题的解决方法。GPT-3 在 few-shot 上展现的强大能力,为 NLP 的突破带来了重要进展。如果对于绝大部分任务都可以通过人为构造 3~5个示例就能让模型解决,其效率将远高于传统的预训练-微调范式,意味着 NLP 的进一步落地应用成为可能——而这,也正是 LLM 的核心优势。
在 GPT 系列模型的基础上,通过引入预训练-指令微调-人类反馈强化学习的三阶段训练,OpenAI 发布了跨时代的 ChatGPT,引发了大模型的热潮。也正是在 GPT-3 及 ChatGPT 的基础上,LLaMA、ChatGLM 等模型的发布进一步揭示了 LLM 的无尽潜力。在下一节,我们将深入剖析目前 LLM 的普适架构——LLaMA。
总结要点:参数量变大;zero-shot;few-shot
3.3.2 LLaMA
由Meta(前Facebook)开发
(1)模型架构–Decoder Only
alt text整体架构和GPT类似,只是在模型规模和预训练数据集有区别 位置编码部分也有区别:方式和时机 LLaMA:旋转编码(相对位置),在注意力机制中 GPT:正弦函数,余弦函数(绝对位置);在Embedding之后
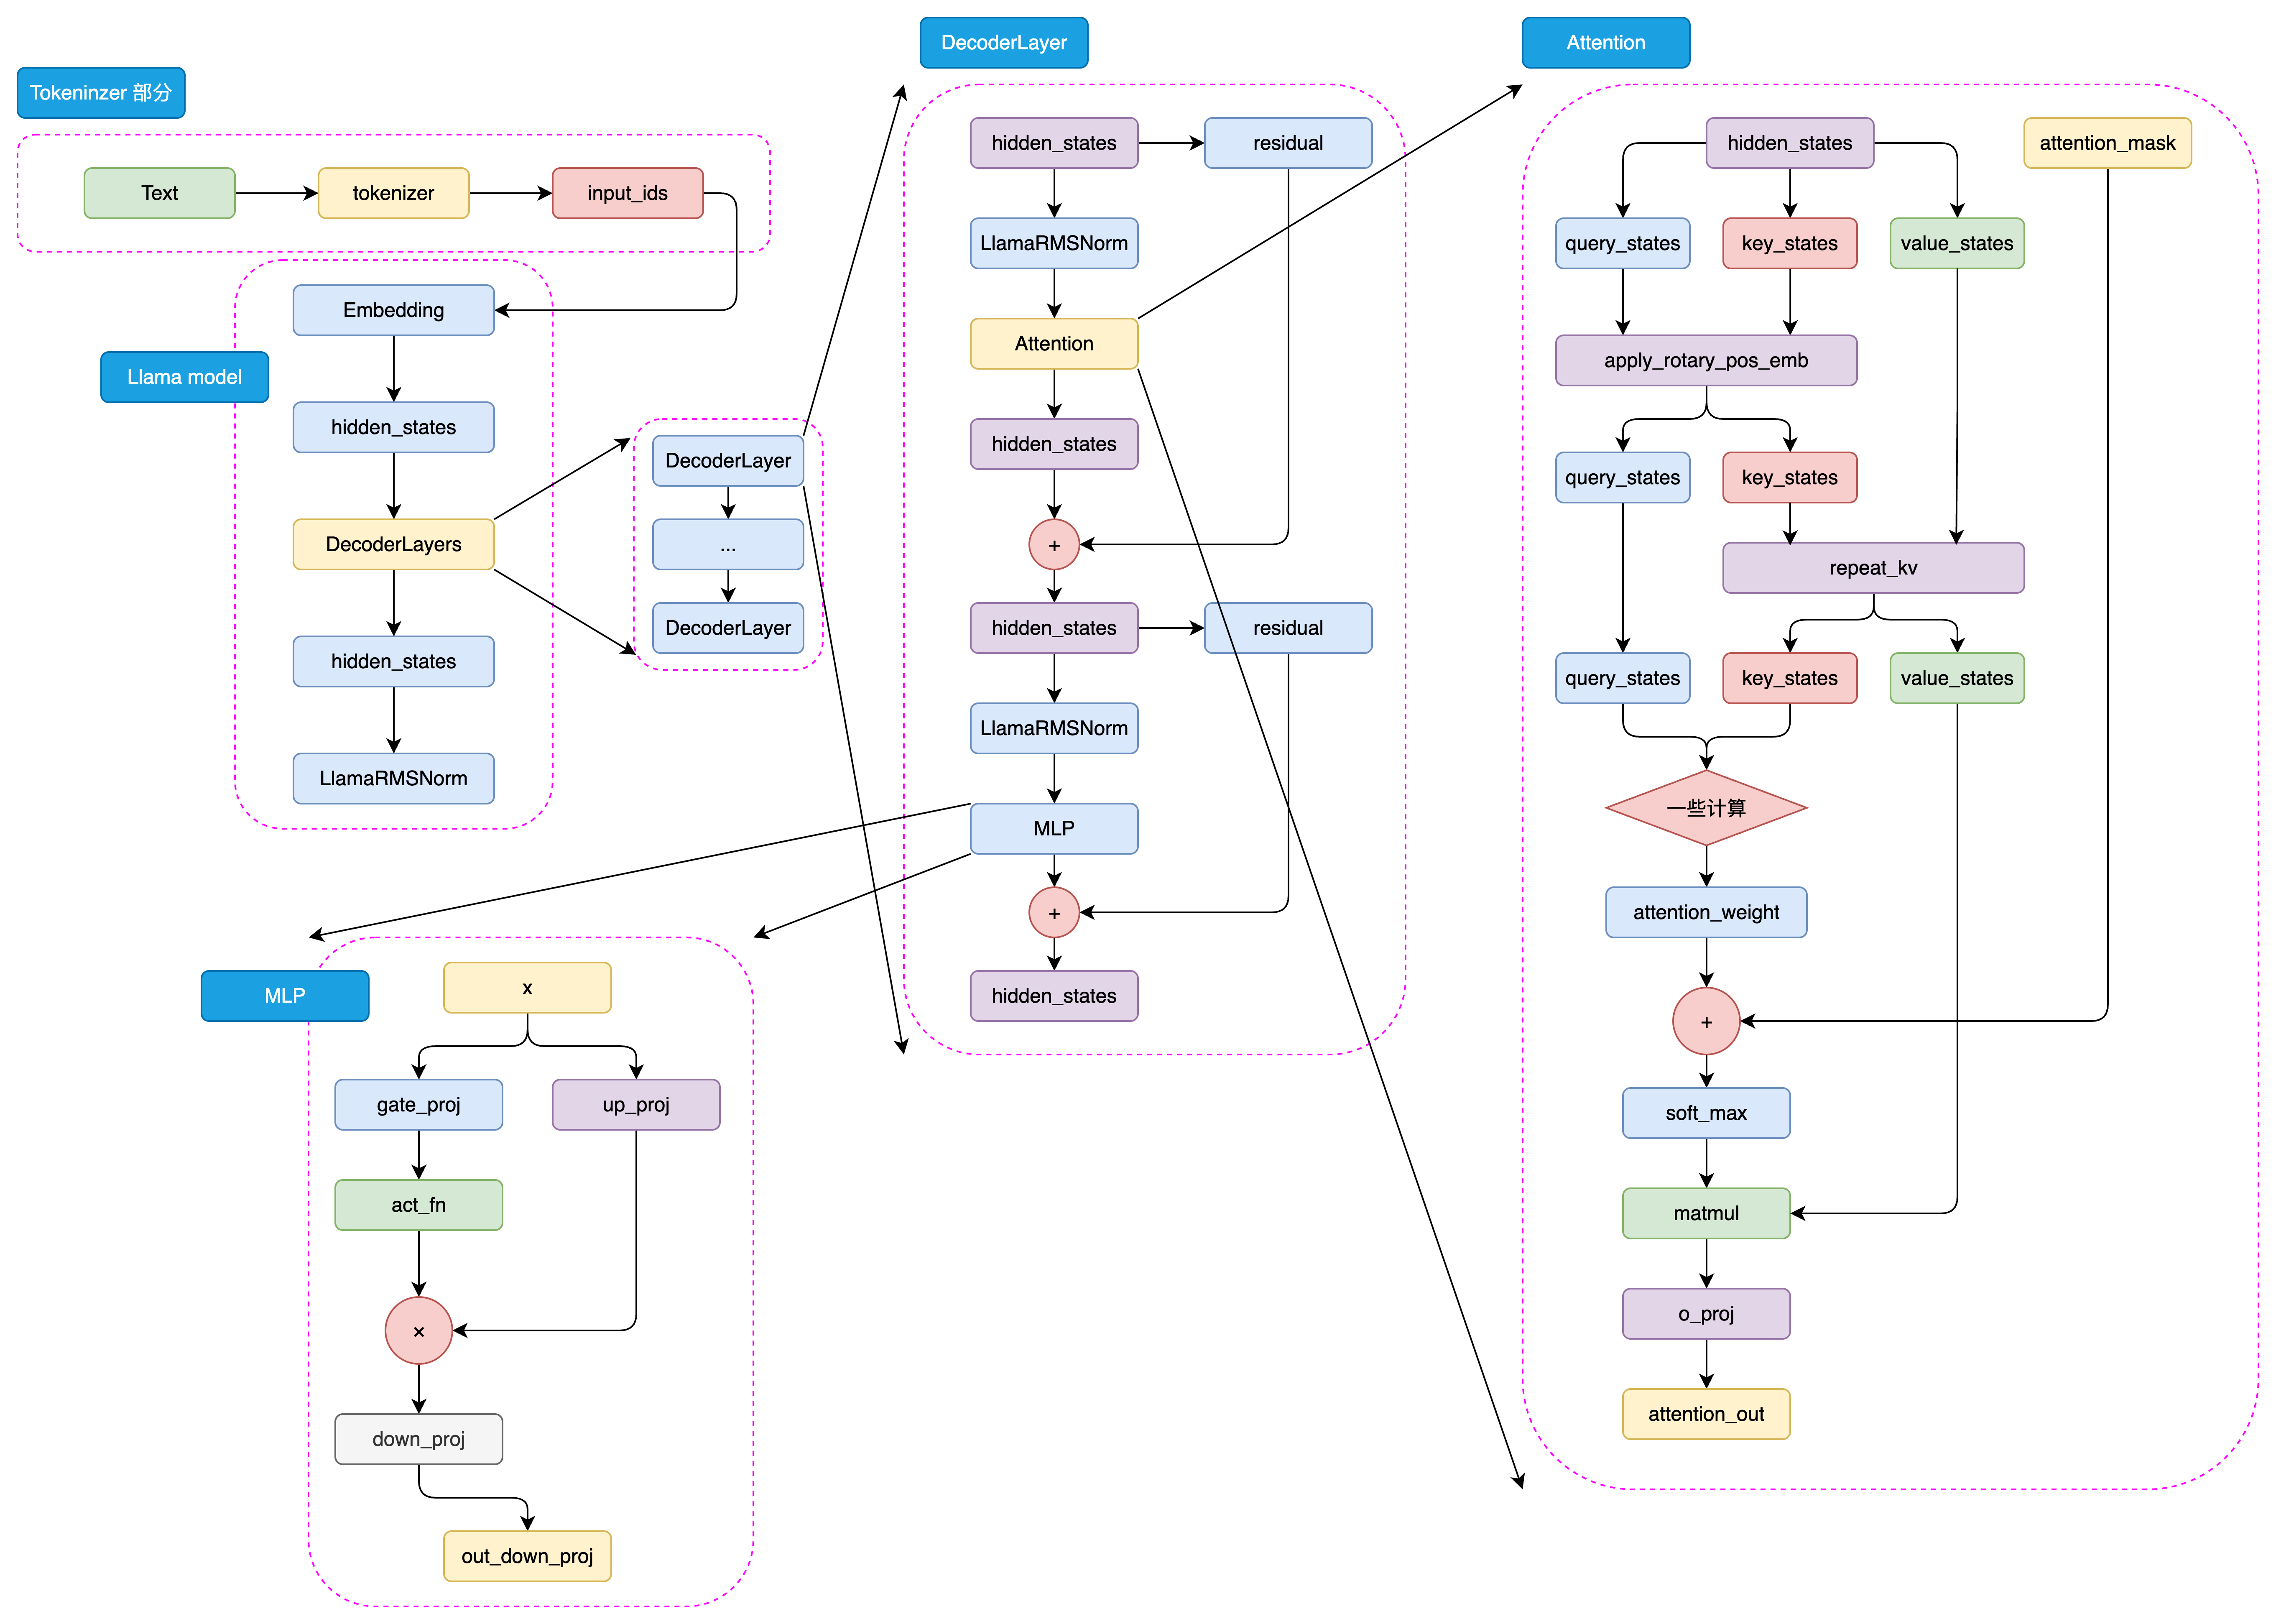
与GPT类似,LLaMA模型的处理流程也始于将输入文本通过tokenizer进行编码,转化为一系列的input_ids。这些input_ids是模型能够理解和处理的数据格式。接下来,这些input_ids会经过embedding层的转换,这里每个input_id会被映射到一个高维空间中的向量,即词向量。同时,输入文本的位置信息也会通过positional embedding层被编码,以确保模型能够理解词序上下文信息。
这样,input_ids经过embedding层和positional embedding层的结合,形成了hidden_states。hidden_states包含了输入文本的语义和位置信息,是模型进行后续处理的基础,hidden_states随后被输入到模型的decoder层。
在decoder层中,hidden_states会经历一系列的处理,这些处理由多个decoder block组成。每个decoder block都是模型的核心组成部分,它们负责对hidden_states进行深入的分析和转换。在每个decoder block内部,首先是一个masked self-attention层。在这个层中,模型会分别计算query、key和value这三个向量。这些向量是通过hidden_states线性变换得到的,它们是计算注意力权重的基础。然后使用softmax函数计算attention score,这个分数反映了不同位置之间的关联强度。通过attention score,模型能够确定在生成当前词时,应该给予不同位置的hidden_states多大的关注。然后,模型将value向量与attention score相乘,得到加权后的value,这就是attention的结果。
在完成masked self-attention层之后,hidden_states会进入MLP层。在这个多层感知机层中,模型通过两个全连接层对hidden_states进行进一步的特征提取。第一个全连接层将hidden_states映射到一个中间维度,然后通过激活函数进行非线性变换,增加模型的非线性能力。第二个全连接层则将特征再次映射回原始的hidden_states维度。
最后,经过多个decoder block的处理,hidden_states会通过一个线性层进行最终的映射,这个线性层的输出维度与词表维度相同。这样,模型就可以根据hidden_states生成目标序列的概率分布,进而通过采样或贪婪解码等方法,生成最终的输出序列。这一过程体现了LLaMA模型强大的序列生成能力。
(2) 发展历程
LLaMA-1 系列:
- Meta于2023年2月发布了LLaMA-1,包括7B、13B、30B和65B四个参数量版本。
- 这些模型在超过1T token的语料上进行了预训练,其中最大的65B参数模型在2,048张A100 80G GPU上训练了近21天。
- LLaMA-1因其开源性和优异性能迅速成为开源社区中最受欢迎的大模型之一。
LLaMA-2 系列:
- 2023年7月,Meta发布了LLaMA-2,包含7B、13B、34B和70B四个参数量版本,除了34B模型外,其他均已开源。
- LLaMA-2将预训练的语料扩充到了2T token,并将模型的上下文长度从2,048翻倍到了4,096。
- 引入了分组查询注意力机制(Grouped-Query Attention, GQA)等技术。
LLaMA-3 系列:
- 2024年4月,Meta发布了LLaMA-3,包括8B和70B两个参数量版本,同时透露400B的LLaMA-3还在训练中。
- LLaMA-3支持8K长文本,并采用了编码效率更高的tokenizer,词表大小为128K。
- 使用了超过15T token的预训练语料,是LLaMA-2的7倍多。
LLaMA模型以其技术创新、多参数版本、大规模预训练和高效架构设计而著称。模型支持从70亿到数百亿不等的参数量,适应不同规模的应用需求。LLaMA-1以其开源性和优异性能迅速受到社区欢迎,而LLaMA-2和LLaMA-3进一步通过引入分组查询注意力机制和支持更长文本输入,显著提升了模型性能和应用范围。特别是LLaMA-3,通过采用128K词表大小的高效tokenizer和15T token的庞大训练数据,实现了在多语言和多任务处理上的重大进步。Meta对模型安全性和社区支持的持续关注,预示着LLaMA将继续作为AI技
3.3.3 GLM
(1)模型框架-相较于GPT的略微修正
GLM 最初是由清华计算机系推出的一种通用语言模型基座,其核心思路是在传统 CLM 预训练任务基础上,加入 MLM 思想,从而构建一个在 NLG 和 NLU 任务上都具有良好表现的统一模型。
- 使用 Post Norm 而非 Pre Norm。Post Norm 是指在进行残差连接计算时,先完成残差计算,再进行 LayerNorm 计算;而类似于 GPT、LLaMA 等模型都使用了 Pre Norm,也就是先进行 LayerNorm 计算,再进行残差的计算。相对而言,Post Norm 由于在残差之后做归一化,对参数正则化的效果更强,进而模型的鲁棒性也会更好;Pre Norm相对于因为有一部分参数直接加在了后面,不需要对这部分参数进行正则化,正好可以防止模型的梯度爆炸或者梯度消失。因此,对于更大体量的模型来说,一般认为 Pre Norm 效果会更好。但 GLM 论文提出,使用 Post Norm 可以避免 LLM 的数值错误(虽然主流 LLM 仍然使用了 Pre Norm);
- 使用单个线性层实现最终 token 的预测,而不是使用 MLP;这样的结构更加简单也更加鲁棒,即减少了最终输出的参数量,将更大的参数量放在了模型本身;
- 激活函数从 ReLU 换成了 GeLUs。ReLU 是传统的激活函数,其核心计算逻辑为去除小于 0的传播,保留大于 0的传播;GeLUs 核心是对接近于 0的正向传播,做了一个非线性映射,保证了激活函数后的非线性输出,具有一定的连续性。
(2)预训练任务-GLM(General Language Model,通用语言模型)
GLM 是一种结合了自编码思想和自回归思想的预训练方法: 所谓自编码思想,其实也就是 MLM 的任务学习思路,在输入文本中随机删除连续的 tokens,要求模型学习被删除的 tokens;所谓自回归思想,其实就是传统的 CLM 任务学习思路,也就是要求模型按顺序重建连续 tokens。
GLM 通过优化一个自回归空白填充任务来实现 MLM 与 CLM 思想的结合。其核心思想是,对于一个输入序列,会类似于 MLM 一样进行随机的掩码,但遮蔽的不是和 MLM 一样的单个 token,而是每次遮蔽一连串 token;模型在学习时,既需要使用遮蔽部分的上下文预测遮蔽部分,在遮蔽部分内部又需要以 CLM 的方式完成被遮蔽的 tokens 的预测。例如,输入和输出可能是:
| |
不过,GLM 预训练任务更多的优势还是展现在预训练模型时代,迈入 LLM 时代后,针对于超大规模、体量的预训练,CLM 展现出远超 MLM 的优势。通过将模型体量加大、预训练规模扩大,CLM 预训练得到的生成模型在文本理解上也能具有超出 MLM 训练的理解模型的能力,因此,ChatGLM 系列模型也仅在第一代模型使用了 GLM 的预训练思想,从 ChatGLM2 开始,还是回归了传统的 CLM 建模。虽然从 LLM 的整体发展路径来看,GLM 预训练任务似乎是一个失败的尝试,但通过精巧的设计将 CLM 与 MLM 融合,并第一时间产出了中文开源的原生 LLM,其思路仍然存在较大的借鉴意义。
(3)GLM家族的发展:
在 GLM 模型(即使用原生 GLM 架构及预训练任务的早期预训练模型)的基础上,参考 ChatGPT 的技术思路进行 SFT 和 RLHF,智谱于 23年 3月发布了第一个中文开源 LLM ChatGLM-6B,成为了众多中文 LLM 研究者的起点。ChatGLM-6B 在 1T 语料上进行预训练,支持 2K 的上下文长度。
在 23年 6月,智谱就开源了 ChatGLM2-6B。相对于一代,ChatGLM2 将上下文长度扩展到了 32K,通过更大的预训练规模实现了模型性能的大幅度突破。不过,在 ChatGLM2 中,模型架构就基本回归了 LLaMA 架构,引入 MQA 的注意力机制,预训练任务也回归经典的 CLM,放弃了 GLM 的失败尝试。
ChatGLM3-6B 发布于 23年 10月,相对于二代在语义、数学、推理、代码和知识方面都达到了当时的 SOTA 性能,但是官方给出的技术报告说明 ChatGLM3 在模型架构上相对二代没有变化,最主要的优化来源是更多样化的训练数据集、更充足的训练步骤和更优化的训练策略。ChatGLM3 的另一个重要改进在于其开始支持函数调用与代码解释器,开发者可以直接使用开源的 ChatGLM3 来实现 Agent 开发,具有更广泛的应用价值。
2024年 1月,智谱发布了支持 128K 上下文,包括多种类型的 GLM-4 系列模型,评估其在英文基准上达到了 GPT-4 的水平。不过,智谱并未直接开源 GLM-4,而是开源了其轻量级版本 GLM-4-9B 模型,其在 1T token 的多语言语料库上进行预训练,上下文长度为 8K,并使用与 GLM-4 相同的管道和数据进行后训练。在训练计算量较少的情况下,其超越了 Llama-3-8B,并支持 GLM-4 中所有工具的功能。