第四章 大语言模型
4.1 什么是LLM
4.4.1 LLM的定义
一般来说,拥有更庞大的参数,在更海量的语料上进行预训练 广义的 LLM 一般覆盖了从十亿参数(如 Qwen-1.5B)到千亿参数(如 Grok-314B)的所有大型语言模型。只要模型展现出涌现能力,即在一系列复杂任务上表现出远超传统预训练模型(如 BERT、T5)的能力与潜力,都可以称之为 LLM。
一般认为,GPT-3是LLM的开端,基于GPT-3通过预训练(Pretraining),监督微调(Supervised Fine-Tuning,SFT),强化学习和人类反馈(Reinforcement Learning with Human Feedback,RLHF)三阶段训练得到的ChatGPT更是主宰了LLM时代的到来
4.1.2 LLM的能力
(1)涌现能力(Emergent Abilities)
区别LLM于传统的PLM最显著的特征就是LLM具备涌现能力: 指的是,在相同的架构和预训练任务下,某些能力在小型模型中不明显,但是在大型模型下非常突出(量变引起质变)
(2)上下文学习(In-context Learning)
有GPT-3首次引入,具体而言,上下文学习指的是: 允许语言模型在提供自然语言指令或多个任务示例的情况下,通过理解上下文并生成相应输出的方式来执行任务,而无需额外的训练或参数更新
而具备上下文学习能力的 LLM 往往无需进行高成本的额外训练或微调,而可以通过少数示例或是调整自然语言指令,来处理绝大部分任务,从而大大节省了算力和数据成本
对于具备上下文学习的LLM来说,一般范式已经开始向Prompt Engineering(调整Prompt)来激发LLM的能力转变
(3)指令遵循(Instruction Following)
指令微调的情况下,也就是使用自然语言描述的多任务数据进行微调 经过指令微调的LLM可以理解并遵循未见过的指令,具有强大的泛化能力
(4)逐步推理(Step by Step Reasoning)
LLM可以通过思维链(Chain of thought,CoT)推理策略,利用包含中间推理步骤的提示机制来解决复杂的逻辑推理任务
4.1.3 LLM的特点
(1)多语言支持
训练的语料本事就是多语言的,但是目前英语的高质量语料仍是占据大多数
(2)长文本支持
一:旋转位置编码(Rotary Positional Encoding,RoPE),具有一定的长度外推能力 二:支持长文本
(3)拓展多模态
图片等等
(4)幻觉
LLM根据Prompt杜撰生成虚假,错误信息的表现 削弱幻觉的方式:Prompt中显式限制,通过RAG来指导生成,但是无法根除
4.2 如何训练一个LLM
训练LLM的三个阶段 alt text
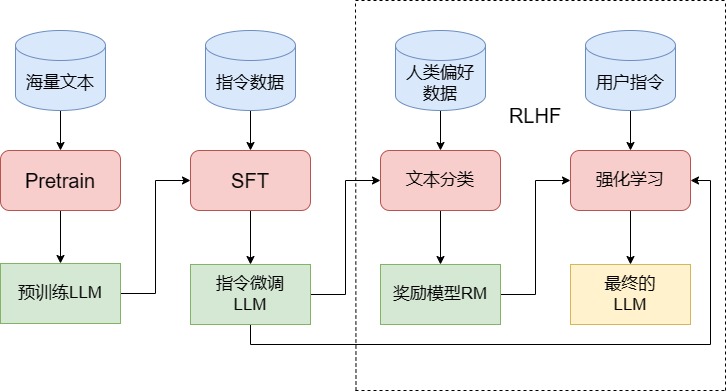
训练一个完整的LLM需要三个阶段–Pretrain,SFT和RLHF
4.2.1 Pretrain
预训练:最核心也是工程量最大的一步 海量无监督文本对随机初始化的模型参数进行训练 由于主流的LLM都采用了Decoder-Only的类GPT框架(LLaMA框架),他们的训练任务为经典预训练任务–因果语言模型(CLM)
LLM预训练于传统模型的预训练的最核心差异在于:预训练的体量和资源消耗 更大的参数量和更海量的语料 训练语料的量: 1.根据由 OpenAI 提出的 Scaling Law:C ~ 6ND,其中 C 为计算量,N 为模型参数,D 为训练的 token 数,可以实验得出训练 token 数应该是模型参数的 1.7倍 2.而 LLaMA 更是进一步提出,使用 20倍 token 来训练模型能达到效果最优
分布式训练框架是LLM训练必不可少的组成部分 核心思路:数据并行和模型并行 数据并行:训练模型的尺寸可以被单个 GPU 内存容纳 但是:由于增大训练的 batch_size 会增大显存开销,无法使用较大的 batch_size 进行训练;训练数据量非常大,使用单张 GPU 训练时长难以接受
但是,当 LLM 扩大到上百亿参数,单张 GPU 内存往往就无法存放完整的模型参数。如图4.3所示,在这种情况下,可以将模型拆分到多个 GPU 上,每个 GPU 上存放不同的层或不同的部分,从而实现模型并行
在此思想基础上,还演化出了其他的方式,例如: 张量并行、3D 并行、ZeRO(Zero Redundancy Optimizer,零冗余优化器) 主流的分布式训练框架包括:Deepspeed、Megatron-LM、ColossalAI 等,其中,Deepspeed 使用面最广
DeepSpeed的核心策略是ZeRO和CPU-offload ZeRO是一种显存优化的数据并行方案,其核心思想是:优化数据并行的每张卡的显存占用,从而实现对更大规模模型的支持 它将模型训练阶段每张卡被占用的显存分为两类:
- 模型状态(Model States),包括模型参数、模型梯度和优化器 Adam 的状态参数。假设模型参数量为 1M,一般来说,在混合精度训练的情况下,该部分需要 16M 的空间进行存储,其中 Adam 状态参数会占据 12M 的存储空间。
- 剩余状态(Residual States),除了模型状态之外的显存占用,包括激活值、各种缓存和显存碎片
针对上述显存占用,ZeRO 提出了三种不断递进的优化策略:
- ZeRO-1,对模型状态中的 Adam 状态参数进行分片,即每张卡只存储 1NN1 的 Adam 状态参数,其他参数仍然保持每张卡一份。
- ZeRO-2,继续对模型梯度进行分片,每张卡只存储 1NN1 的模型梯度和 Adam 状态参数,仅模型参数保持每张卡一份。
- ZeRO-3,将模型参数也进行分片,每张卡只存储 1NN1 的模型梯度、模型参数和 Adam 状态参数。
随着分片的参数量不断增加,每张卡需要占用的显存也不断减少。当然,分片的增加也就意味着训练中通信开销的增加,每张卡的 GPU 利用率 ZeRO-1 最高而 ZeRO-3 最低
另一大挑战:训练数据本身:LLM的大部分知识都是在预训练中获得的,因此预训练的语料应该组织多种来源的数据并且以一定比例进行混合 事实上,数据配比向来是预训练 LLM 的“核心秘籍”,不同的配比往往会相当大程度影响最终模型训练出来的性能 问题:目前高质量的语料大部分还是集中在英文范畴
预训练数据的处理与清洗也是一个重要环节:预训练数据的质量往往比体量更重要,
预训练数据处理一般包含以下流程:
- 文档准备。由于海量预训练语料往往是从互联网上获得,一般需要从爬取的网站来获得自然语言文档。文档准备主要包括 URL 过滤(根据网页 URL 过滤掉有害内容)、文档提取(从 HTML 中提取纯文本)、语言选择(确定提取的文本的语种)等。
- 语料过滤。语料过滤的核心目的是去除低质量、无意义、有毒有害的内容,例如乱码、广告等。语料过滤一般有两种方法:基于模型的方法,即通过高质量语料库训练一个文本分类器进行过滤;基于启发式的方法,一般通过人工定义 web 内容的质量指标,计算语料的指标值来进行过滤。
- 语料去重。实验表示,大量重复文本会显著影响模型的泛化能力,因此,语料去重即删除训练语料中相似度非常高的文档,也是必不可少的一个步骤。去重一般基于 hash 算法计算数据集内部或跨数据集的文档相似性,将相似性大于指定阈值的文档去除;也可以基于子串在序列级进行精确匹配去重。
目前有很多经过处理的高质量预训练语料专用于预训练数据处理的框架
有基于 LLaMA 思路收集、清洗的预训练数据集RedPajama-1T,以及在 RedPajama 基础上进行筛选去重的SlimPajama-627B数据集,实验证明高质量的 627B Slimpajama 数据集能够获得比 1T 的 RedPajama 数据集更好的效果。 (客观论证了预训练数据的质量比体量更重要)
4.2.2 SFT(有监督微调)
通过选择训练模型的"通用指令遵循能力",也就是一般通过指令微调的方式来进行SFT
SFT的主要目标就是让模型从多种类型,多种风格的指令中获得泛化的指令遵循能力,也就是能够理解和回复用户的指令 因此:SFT的数据质量和数据配比也是决定模型指令遵循能力的重要因素
首先是指令数据量以及覆盖范围: 需要收集类别各异的用户指令和对应回复对LLM进行训练,为了使得泛化的指令遵循能力,需要在训练数据集中覆盖多种类型的任务指令,也需要较大的数据量
不同类型的指令数据中间的配比也是LLM训练的一大挑战:
高质量的指令数据集具有较高的获取难度。不同于预训练使用的无监督语料,SFT 使用的指令数据集是有监督语料,除去设计广泛、合理的指令外,还需要对指令回复进行人工标注,并保证标注的高质量
为降低数据成本,部分学者提出了使用 ChatGPT 或 GPT-4 来生成指令数据集的方法。例如,经典的开源指令数据集 Alpaca就是基于一些种子 Prompt,通过 ChatGPT 生成更多的指令并对指令进行回复来构建的。
一般 SFT 所使用的指令数据集包括以下三个键:
| |
同时,为使模型能够学习到和预训练不同的范式,在 SFT 的过程中,往往会针对性设置特定格式。例如,LLaMA 的 SFT 格式为:
| |
其中的 content 即为具体的用户指令,也就是说,对于每一个用户指令,将会嵌入到上文的 content 部分,这里的用户指令不仅指上例中的 “instruction”,而是指令和输入的拼接,即模型可以执行的一条完整指令。例如,针对上例,LLaMA 获得的输入应该是:
| |
注意,因为指令微调本质上仍然是对模型进行 CLM 训练,只不过要求模型对指令进行理解和回复而不是简单地预测下一个 token,所以模型预测的结果不仅是 output,而应该是 input + output,只不过 input 部分不参与 loss 的计算,但回复指令本身还是以预测下一个 token 的形式来实现的。
模型是否支持多轮对话,与预训练是没有关系的。事实上,模型的多轮对话能力完全来自于 SFT 阶段。如果要使模型支持多轮对话,我们需要在 SFT 时将训练数据构造成多轮对话格式,让模型能够利用之前的知识来生成回答
构造多轮对话样本一般有三种方式: 1.直接将最后一次模型回复作为输出,前面所有历史会话作为输入,直接拟合最后一次回复 2.将N轮多花构造成N个样本 3.直接要求模型预测每一轮对话的输出
第一种方式会丢失大量中间信息,第二种方式造成了大量重复计算,只有第三种方式是最合理的多轮对话构造。
我们之所以可以以第三种方式来构造多轮对话样本,是因为 LLM 本质还是进行的 CLM 任务,进行单向注意力计算,因此在预测时会从左到右依次进行拟合,前轮的输出预测不会影响后轮的预测。目前,绝大部分 LLM 均使用了多轮对话的形式来进行 SFT
4.2.3 RLHF(人类反馈强化学习)
利用强化学习来训练LLM的关键步骤 RLHF往往被认为ChatGPT相较于GPT3最核心的突破 从功能上出发,我们可以将LLM的训练过程分为预训练与对齐两个阶段
预训练的核心功能是赋予模型海量知识;二对齐,则是让模型与人类价值观一致,从而输出人类希望输出的内容 SFT是让LLM和人类指令对齐,从而拥有指令遵循的能力;而RLHF则是从更深层次使LLM与人类价值观对齐,从而达到安全有用无害的和核心标准
ChatGPT在技术报告中的对齐分为三个阶段:后面两个阶段训练RM和PPO训练,就是RLHF的步骤 alt text
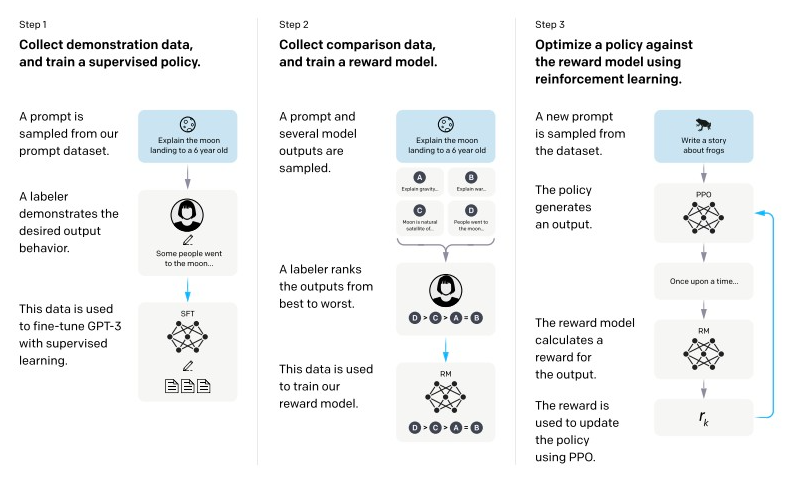
RLHF的思路:引入强化学习的技术,通过实时的人类反馈零LLM能够给出更令人满意的回复 强化学习是有别于监督学习的另一种机器学习的方法,主要由两个部分构成:智能体和环境
pretrain传授基础知识;SFT教他怎么做题;RLHF类似于真正的训练
RLHF分为两个步骤:训练RM和PPO训练 RM: Reward Model 即奖励模型 本质上是一个文本分类模型
RM,Reward Model,即奖励模型。RM 是用于拟合人类偏好,来给 LLM 做出反馈的。在强化学习的训练中,对于 LLM 的每一个回复,RM 会进行打分,这个打分反映了生成回复符合人类偏好的程度。然后 LLM 会根据强化学习的原理,基于 RM 的打分来进行优化训练。所以,RM 本质上是一个文本分类模型,对于一个文本输出一个标量奖励,和文本分类任务中的隐藏层输出非常类似。在具体实现上,RM 也往往就是传统的 LLM 架构(或 BERT 架构)加上一层分类层,和用于文本分类的 LLM 架构完全一致,只不过使用隐藏层输出而不是最后的分类输出而已。
但是,在训练 RM 时,我们往往并不直接使用文本及其对应的标量奖励来对 RM 进行训练。因为要对齐人类偏好,RM 训练的偏好数据往往是由人工标注的。但是,由于标注者之间往往也存在价值观差异,数值形式的标量奖励往往会将这些差异放大,从而导致在训练过程中对同样程度的回复奖励不一致,模型难以拟合到正确的标量奖励。因此,我们往往对同一个 completion 下的不同回复进行排名,再将排名转化为奖励。
例如,我们的训练数据往往形如:
| |
其中,prompt 是用户的问题,chosen 是应该对齐的、符合人类偏好的回答,rejected 是不符合人类偏好的回答。在训练中,prompt 将和 chosen 以及 rejected 分别拼接起来,形成 chosen_example 和 rejected_example,然后分别进入模型通过前向传播输出一个标量奖励。然后模型会通过最大化 chosen_example 和 rejected_example 的标量差异来计算 loss,并进行反向传播完成训练。
值得注意的是,RM 训练使用的模型往往和最后的 LLM 大小不同。例如 OpenAI 使用了 175B 的 LLM 和 6B 的 RM。同时,RM 使用的模型可以是经过 SFT 之后的 LM,也可以是基于偏好数据从头训练的 RM。哪一种更好,至今尚没有定论。
在完成 RM 训练之后,就可以使用 PPO 算法来进行强化学习训练。PPO,Proximal Policy Optimization,近端策略优化算法,是一种经典的 RL 算法。事实上,强化学习训练时也可以使用其他的强化学习算法,但目前 PPO 算法因为成熟、成本较低,还是最适合 RLHF 的算法。
在具体 PPO 训练过程中,会存在四个模型。如图4.5所示,两个 LLM 和两个 RM。两个 LLM 分别是进行微调、参数更新的 actor model 和不进行参数更新的 ref model,均是从 SFT 之后的 LLM 初始化的。两个 RM 分别是进行参数更新的 critic model 和不进行参数更新的 reward model,均是从上一步训练的 RM 初始化的。
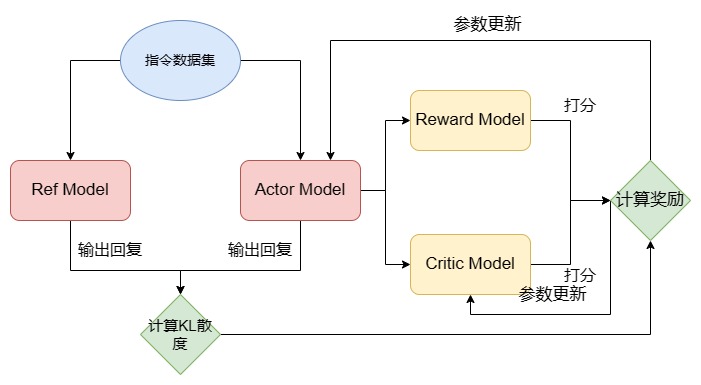
图4.5 PPO 训练流程
如上图,使用 PPO 算法的强化学习训练过程如下:
- 从 SFT 之后的 LLM 初始化两个模型分别作为 Actor Model 和 Ref Model;从训练的 RM 初始化两个模型分别作为 Reward Model 和 Critic Model;
- 输入一个 Prompt,Actor Model 和 Ref Model 分别就 Prompt 生成回复;
- Actor Response 和 Ref Response 计算 KL 散度: rKL=−θKLDKL(πPPO(y∣x)∣∣πbase(y∣x))rKL=−θKLDK**L(πPP**O(y∣x)∣∣πbase(y∣x)) 其中, πPPO(y∣x)πPP**O(y∣x) 即为 Actor Model 的输出,而 πbase(y∣x)πbase(y∣x) 即为 Ref Model 的输出, θKLDKLθKLDK**L 即是计算 KL 散度的方法;
- Actor Response 分别输入到 Reward Model 和 Critic Model 进行打分,其中,Reward Model 输出的是回复对应的标量奖励,Critic Model 还会输出累加奖励(即从i位置到最后的累积奖励);
- 计算的 KL 散度、两个模型的打分均输入到奖励函数中,计算奖励: loss=−(klctl⋅rKL+γ⋅Vt+1−Vt)logP(At∣Vt)l**oss=−(klc**tl⋅rKL+γ⋅V**t+1−V**t)logP(A**t∣V**t) ,这里的 klctlklc**tl 是控制 KL 散度对结果影响的权重参数, γγ 是控制下一个时间(也就是样本)打分对结果影响的权重参数, VtV**t 是 Critic Model 的打分输出, AtA**t 则是 Reward Model 的打分输出;
- 根据奖励函数分别计算出的 actor loss 和 critic loss,更新 Actor Model 的参数和 Critic Model 的参数;注意,Actor Model 和 Critic Model 的参数更新方法是不同的,此处就不再一一赘述了,感兴趣的读者可以深入研究强化学习的相关理论。
在上述过程中,因为要使用到四个模型,显存占用会数倍于 SFT。例如,如果我们 RM 和 LLM 都是用 7B 的体量,PPO 过程中大概需要 240G(4张 80G A100,每张卡占用 60G)显存来进行模型加载。那么,为什么我们需要足足四个模型呢?Actor Model 和 Critic Model 较为容易理解,而之所以我们还需要保持原参数不更新的 Ref Model 和 Reward Model,是为了限制模型的更新不要过于偏离原模型以至于丢失了 Pretrain 和 SFT 赋予的能力。
当然,如此大的资源占用和复杂的训练过程,使 RLHF 成为一个门槛非常高的阶段。也有学者从监督学习的思路出发,提出了 DPO(Direct Preference Optimization,直接偏好优化),可以低门槛平替 RLHF。DPO 的核心思路是,将 RLHF 的强化学习问题转化为监督学习来直接学习人类偏好。DPO 通过使用奖励函数和最优策略间的映射,展示了约束奖励最大化问题完全可以通过单阶段策略训练进行优化,也就是说,通过学习 DPO 所提出的优化目标,可以直接学习人类偏好,而无需再训练 RM 以及进行强化学习。由于直接使用监督学习进行训练,DPO 只需要两个 LLM 即可完成训练,且训练过程相较 PPO 简单很多,是 RLHF 更简单易用的平替版本